Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Table of Contents
Podsumowanie
LLM-y open source, takie jak Llama, DeepSeek i Mistral, mogą zapewnić firmom niższe koszty, lepszą ochronę danych i większe możliwości dostosowania niż modele zamknięte, takie jak GPT czy Claude.
W zamian wymagają kompetencji technicznych i inwestycji w infrastrukturę, których nie widać za hasłem „darmowe do pobrania”. Dziś większość firm nadal domyślnie wybiera zamknięte API i zwykle jest to właściwa decyzja.
Zespoły, które odnoszą sukcesy z rozwiązaniami open source, traktują je jako jedno z kilku narzędzi i często działają w modelu hybrydowym, używając każdego z nich tam, gdzie to się opłaca.
Na początku 2025 roku, gdy wszyscy sądzili, że czołowe zachodnie laboratoria AI, takie jak OpenAI i Anthropic, są nie do pokonania, chińskie modele DeepSeek wywróciły wszystko do góry nogami.
Były tańsze, otwarte, można je było uruchamiać lokalnie, a ich wydajność była niepokojąco bliska modelom od OpenAI.
Od tego czasu entuzjazm wobec DeepSeek — i wobec LLM-ów open source w ogóle — osłabł. Według danych z połowy 2025 roku firmy wydają prawie 8,4 mld USD (wzrost z 3,5 mld USD w 2024 roku) na dostęp przez API do dużych modeli językowych, a modele DeepSeek stanowią zaledwie 1% tej kwoty.
Zwyciężyły modele zamknięte. Tylko 13% obciążeń AI korzysta dziś z modeli open source, a na czele stawki znajdują się modele Llama od Meta.
Modele open source nadal mają realne zalety i dobrze sprawdzają się w określonych zastosowaniach, nawet jeśli nie są najlepszym wyborem tam, gdzie potrzebna jest wydajność z absolutnej czołówki.
Ekosystem LLM-ów open source również stale się rozwija, więc warto być na bieżąco i wiedzieć, kiedy te modele mają sens biznesowy, jakie wyzwania ze sobą niosą oraz jak zacząć z nich korzystać.
Czym są LLM-y open source? Wyjaśnienie kluczowych pojęć
Jeśli korzystasz z ChatGPT, masz już pewne wyobrażenie o tym, co potrafi duży model językowy. To, co sprawia, że LLM jest „open source”, wymaga nieco szerszego wyjaśnienia.
Mówiąc o LLM-ach open source, mamy na myśli modele, których wagi są publicznie dostępne do używania, modyfikowania i rozpowszechniania przez każdego, choć niektóre modele wymagają zgody albo ograniczają pewne zastosowania komercyjne.
To odróżnia je od tradycyjnego oprogramowania open source, w którym otrzymujesz sam kod źródłowy.
W przypadku LLM-ów dostajesz gotowy, wytrenowany model — rezultat milionów dolarów i ogromnych zasobów obliczeniowych zainwestowanych w trening.
Zawsze sprawdzaj licencję dołączoną do modelu, bo nie wszystkie są udostępniane na liberalnych licencjach, takich jak Apache 2.0. Te szczegóły wpływają na to, co możesz legalnie zrobić z modelem i jak dużej zależności od dostawcy faktycznie unikasz.
Kluczowe pojęcia związane z LLM-ami open source
Kilka terminów technicznych pojawia się tu regularnie.
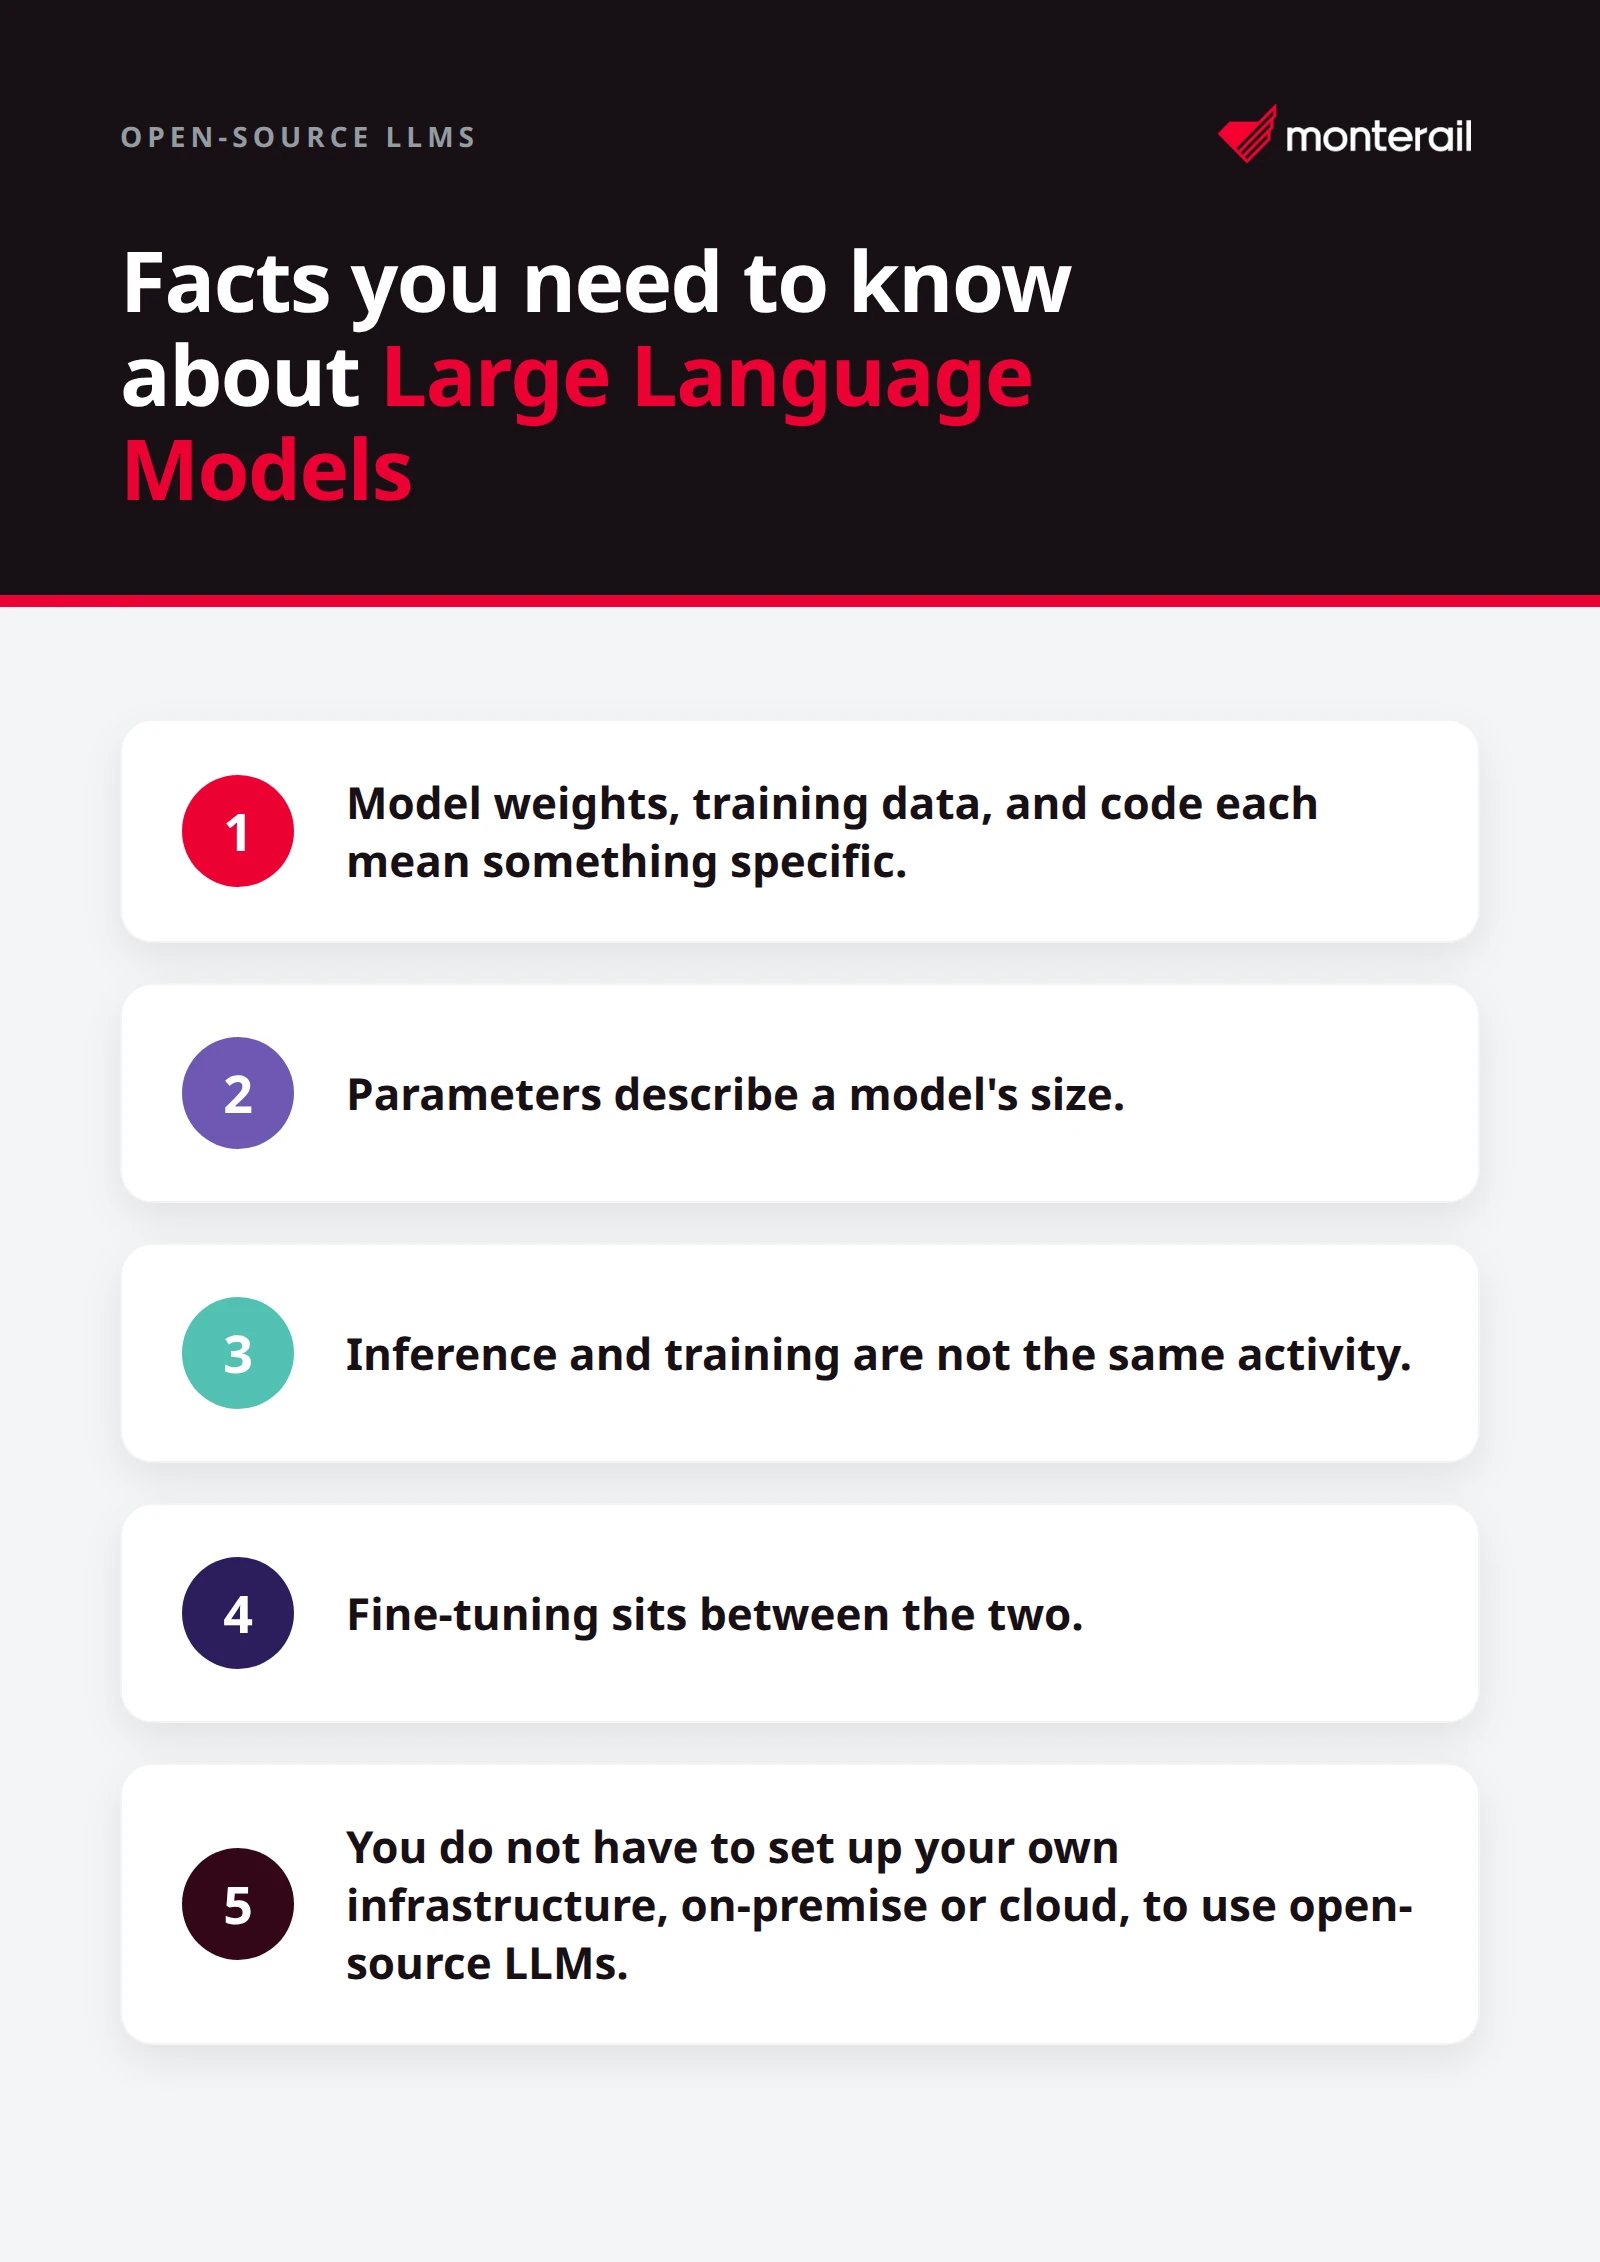
Wagi modelu, dane treningowe i kod — każde z tych pojęć oznacza coś konkretnego. Wagi to sam wytrenowany model. Dane treningowe to to, czego użyto do jego nauczenia — często pozostają prywatne. Kod opisuje architekturę modelu i sposób jego działania. Większość LLM-ów open source daje dostęp do wag i kodu, a niektóre również do danych treningowych. Z perspektywy biznesowej kluczowy jest dostęp do wag.
Parametry opisują wielkość modelu. Zobaczysz oznaczenia modeli takie jak „7B”, „70B” czy „405B”, czyli miliardy parametrów. W dużym uproszczeniu więcej parametrów często oznacza większe możliwości, ale też większe zapotrzebowanie na moc obliczeniową przy ich uruchamianiu. Model z 7 miliardami parametrów może sprawnie obsługiwać zapytania do działu wsparcia klienta, podczas gdy model z 70 miliardami parametrów może poradzić sobie ze złożoną analizą prawną.
Wnioskowanie i trening to nie to samo. Trening oznacza tworzenie modelu od podstaw, co jest skrajnie kosztowne i zbędne dla niemal każdej firmy. Wnioskowanie to korzystanie z już wytrenowanego modelu do generowania wyników — i właśnie tym będziesz się zajmować. To rozróżnienie ma znaczenie, bo rozmowy o infrastrukturze i kosztach wokół LLM-ów open source dotyczą niemal wyłącznie wnioskowania, a nie treningu.
Pomiędzy nimi znajduje się fine-tuning. To wykorzystanie wysokiej jakości, wyspecjalizowanego zbioru danych do dalszego trenowania istniejącego modelu pod niszowy przypadek użycia. Nadal wymaga inwestycji, ale znacznie mniejszej niż trenowanie modelu od podstaw.
Aby korzystać z LLM-ów open source, nie musisz stawiać własnej infrastruktury — ani lokalnie, ani w chmurze. Platformy takie jak Together.ai i OpenRouter mogą zrobić to za ciebie, a wszyscy czołowi dostawcy chmury (AWS, Google Cloud, Azure) oferują usługi zarządzane, które upraszczają tworzenie i wdrażanie otwartych modeli.
Najlepsze modele open source i najważniejsze rankingi otwartych LLM-ów
Znalezienie odpowiedniego modelu open source do twojego zastosowania może być trudne, biorąc pod uwagę, jak wiele ich jest.
Rankingi pomagają zawęzić wybór. Według rankingu LLM Stats, który wydaje się najbardziej kompleksowy, najlepsze otwarte LLM-y we wrześniu 2025 roku to:
Te modele zajmują wysokie miejsca także w innych rankingach. Poszczególne rankingi oferują różne benchmarki i charakterystyki modeli, więc bardziej przydatne informacje możesz znaleźć w:
rankingu Open LLM Leaderboard od Vellum (szczególnie przydatnym do oceny modeli według różnych zadań lub metryk wydajności)
Czołówka modeli open source szybko się zmienia. Francuskie modele Mistral kiedyś przewodziły w kategorii otwartej; dziś dominują chińskie modele, takie jak Qwen i DeepSeek. Mało kto spodziewał się, że OpenAI kiedykolwiek wypuści otwarty model, a jednak GPT OSS konkuruje dziś z najlepszymi, obok mocnych otwartych modeli od Meta i Google.
Wysoki wynik w rankingu nie oznacza automatycznie, że model pasuje do twojego zastosowania. Rankingi i benchmarki mogą ci pomóc tylko do pewnego momentu.
Aby znaleźć właściwy model, musisz go testować i oceniać. Dobrym punktem wyjścia jest rozmowa z różnymi modelami na platformie takiej jak LMArena lub OpenRouter.
Aby ułatwić ci wybór, oto dwie rekomendacje ekspertów AI z GitHub:
Sprawdź, jak dobrze model radzi sobie z konkretnym zadaniem, na którym najbardziej ci zależy.
Weź pod uwagę koszt działania modelu i jego całkowite opóźnienie.
Zalety modeli LLM open source
Firmy wybierają modele LLM open source z kilku powodów:
Kontrola kosztów
Prywatność i bezpieczeństwo danych
Możliwość dostosowania
Przejrzystość i zarządzanie ryzykiem
Brak uzależnienia od dostawcy
Wsparcie społeczności
Kontrola kosztów i przewidywalność
Modele własnościowe zwykle rozliczają się za token, a przy większej skali te koszty szybko rosną. Dla firm prowadzących działalność na dużą skalę oznacza to dwa problemy: rosnące koszty i nieprzewidywalne budżety.
Dzięki modelom LLM open source możesz osiągnąć podobną wydajność przy niższym i bardziej stabilnym budżecie.
Prywatność i bezpieczeństwo danych
Gdy wysyłasz dane do zewnętrznego API, powierzasz zewnętrznemu dostawcy potencjalnie wrażliwe informacje: dane klientów, zastrzeżone strategie, poufną komunikację lub dane objęte regulacjami.
Modele LLM open source można wdrażać we własnej infrastrukturze, więc wrażliwe informacje nigdy nie opuszczają twojego środowiska. W silnie regulowanych branżach może to być twardy wymóg.
Na przykład jedna firma farmaceutyczna korzystała z zamkniętych modeli LLM w wewnętrznych chatbotach, ale wdrożyła bezpieczny model Llama specjalnie do wykrywania danych umożliwiających identyfikację osób.
Dostosowanie i przewaga konkurencyjna
W przypadku własnościowych API wiodących modeli zwykle dostajesz te same narzędzia, z których korzystają wszyscy inni, i masz ograniczone możliwości dostosowania. Z kolei modele open source możesz dostroić na własnych danych, by zbudować realną przewagę konkurencyjną.
Dostrajanie na danych specyficznych dla danej dziedziny zwiększa trafność i dokładność w kontekście konkretnego biznesu. Kancelaria może trenować modele na własnych precedensach, producent może nauczyć modele swoich specyfikacji technicznych, a detalista może osadzić w nich ton komunikacji marki i wiedzę o produktach.
Przejrzystość i zarządzanie ryzykiem
W przeciwieństwie do własnościowych modeli typu black box modele LLM open source dają większy wgląd w architekturę modelu, dane treningowe i algorytmy. Taka przejrzystość wspiera szczegółowe audyty integralności i wydajności modelu, co może mieć znaczenie dla nadzoru i zarządzania ryzykiem.
Gdy coś idzie nie tak w przypadku własnościowego API, zależysz od dostawcy, który musi zdiagnozować problem i go naprawić. Przy modelach open source twój zespół może sam zbadać problem, znaleźć jego podstawową przyczynę i od razu wdrożyć poprawki. Taki poziom kontroli ma dużą wartość, gdy coś przestaje działać w najgorszym możliwym momencie.
Brak uzależnienia od dostawcy
Elastyczność strategiczna ma znaczenie. W przypadku usług własnościowych jesteś narażony na zmiany cen, wycofywanie funkcji, zakończenie świadczenia usług i zmianę priorytetów dostawcy. Czołowe laboratoria AI zmieniają ceny, modyfikują działanie API albo wycofują starsze modele, często bez większego uprzedzenia, przez co klienci muszą w pośpiechu się dostosowywać.
Modele LLM open source eliminują to uzależnienie i dają ci swobodę przechodzenia między modelami lub dostawcami wraz z rozwojem technologii. Jeśli pojawi się lepszy model, możesz przeprowadzić migrację. Jeśli dane podejście się nie sprawdza, możesz zmienić kierunek. Decyzja pozostaje po twojej stronie.
Dostęp do innowacji i społeczności
Społeczność open source wokół AI rozwija się bardzo szybko. Od początku 2023 roku liczba premier nowych modeli open source niemal się podwoiła w porównaniu z ich zamkniętymi odpowiednikami. Nowe techniki, optymalizacje i możliwości pojawiają się bez przerwy.
Społeczność dzieli się też wiedzą, dobrymi praktykami, narzędziami i integracjami firm trzecich oraz benchmarkami porównawczymi. Nie rozwiązujesz problemów w pojedynkę, bo tysiące deweloperów i organizacji pracują nad podobnymi wyzwaniami i publikują to, co się sprawdza.
Wyzwania związane z modelami LLM open source
Modele LLM open source nie są rozwiązaniem typu plug and play, a każdy, kto mówi ci, że są „darmowe”, wprowadza cię w błąd. Same modele można pobrać bez opłat, ale wdrożenie, infrastruktura, utrzymanie i specjalistyczna wiedza wiążą się z realnymi kosztami. Zrozumienie tych wyzwań z góry jest niezbędne, by podejmować trafne decyzje.
Jako przykład poniżej znajdziesz krótkie zestawienie czynników kosztowych dla kilku czołowych modeli open source z bloga Latitude:
LLaMA 3: Niestandardowa licencja z ograniczeniami; duże wymagania dotyczące GPU i pamięci; silna społeczność, ale brak oficjalnego wsparcia.
Falcon 180B: Licencja Apache 2.0; wymaga GPU klasy enterprise; mniejsza społeczność, wyższe koszty skalowania.
Mixtral 8x22B: Licencja Apache 2.0; wykorzystuje architekturę mixture-of-experts, by obniżyć koszty; rosnące wsparcie społeczności.
Yi-34B-Chat: Licencja Apache 2.0; umiarkowane koszty; ograniczona społeczność i dostępne opcje wsparcia.
Mistral: Podwójne licencjonowanie (open source i komercyjne); działa wydajnie na standardowych GPU; silna społeczność i opcjonalne wsparcie klasy enterprise.
Wymagania infrastrukturalne i techniczne
Uruchamianie LLM-ów wymaga dużej mocy obliczeniowej. Do użytku osobistego może wystarczyć lokalny LLM uruchamiany na twoim laptopie, ale zastosowania biznesowe wymagają zasobów GPU — w chmurze albo on-premise — oraz sprzętu klasy enterprise w przypadku większych modeli.
Początkowa konfiguracja jest naprawdę złożona. W przeciwieństwie do wykonania wywołania API trzeba skonfigurować infrastrukturę obsługującą modele, przygotować pipeline wdrażania modeli, wdrożyć systemy monitoringu i ustanowić procedury utrzymaniowe. To wszystko zwiększa zarówno złożoność, jak i stałe koszty operacyjne.
Rzeczywisty całkowity koszt utrzymania
Właśnie całkowity koszt utrzymania zaskakuje wiele organizacji. Model możesz pobrać za darmo, ale infrastruktura, licencjonowanie, skalowanie i wsparcie nie są darmowe.
Do ukrytych kosztów należą ciągła ewaluacja i testowanie modeli, debugowanie przypadków brzegowych, obsługa aktualizacji i wersjonowania modeli, skalowanie infrastruktury wraz ze wzrostem użycia oraz prace związane z bezpieczeństwem i zgodnością z przepisami. Te koszty operacyjne mogą przewyższyć początkową inwestycję w sprzęt. Według analizy jednego eksperta z czerwca 2025 roku:
Nawet minimalne wdrożenie wewnętrzne może kosztować od 125 000 do 190 000 USD rocznie.
Funkcja skierowana do klientów wdrożona na średnią skalę to, ostrożnie licząc, koszt od 500 000 do 820 000 USD rocznie.
Kluczowy silnik produktu w skali enterprise kosztuje od 6 mln do ponad 12 mln USD rocznie, przy infrastrukturze obejmującej wiele regionów, wysokiej klasy GPU i wyspecjalizowanym zespole potrzebnym tylko po to, by utrzymać go w dobrej kondycji.
Do ukrytych obciążeń należą degradacja kodu integracyjnego, kruchość zespołu, uzależnienie od stosu OSS, paraliż ewaluacyjny i rosnąca złożoność zgodności z przepisami.
Większość zespołów nie doszacowuje kosztu kapitału ludzkiego ani tempa degradacji modeli i infrastruktury. OSS daje elastyczność — do momentu, w którym zabrniesz zbyt daleko, by zmienić kierunek.
Dlatego due diligence ma znaczenie. Trzeba dokładnie policzyć koszty, żeby ocenić, czy w twoim przypadku więcej sensu ma model open source czy własnościowe API.
Kompromisy między wydajnością a jakością
Mniejsze modele open source będą wypadać słabiej niż czołowe modele własnościowe OpenAI i Anthropic w zadaniach wymagających złożonego rozumowania. Różnica się zmniejszyła, a modele open source doganiają konkurencję w części benchmarków, ale kompromisy wciąż pozostają.
Kluczowe jest dopasowanie rozmiaru i możliwości modelu do konkretnego przypadku użycia. Wydajność w dużej mierze zależy od zastosowania i wymagań i nie ma jednego uniwersalnie „najlepszego” modelu.
Potrzebujesz rzetelnych procesów ewaluacji, procesów walidacyjnych przed wdrożeniem produkcyjnym, ciągłego monitorowania jakości wyników oraz planów awaryjnych na wypadek, gdy modele zawiodą.
Wsparcie i odpowiedzialność
Gdy coś psuje się we własnościowym API, możesz skontaktować się ze wsparciem. W przypadku modeli open source problem jest po twojej stronie. Nie ma linii wsparcia dostawcy, więc pozostają zasoby społeczności albo własna wiedza.
To oznacza, że potrzebujesz wewnętrznych kompetencji, by diagnozować problemy, debugować błędy i wdrażać rozwiązania. Jakość dokumentacji społecznościowej jest różna, a przy mniej popularnych modelach lub przypadkach brzegowych możesz samodzielnie wypracowywać rozwiązanie.
Jest też plus. Nie czekasz na harmonogram poprawek dostawcy i możesz wdrażać obejścia we własnym tempie. Odpowiedzialność jednak w całości spoczywa na tobie.
Kwestie zgodności z przepisami i prawne
Warunki licencji mają znaczenie. Niektóre modele są objęte niestandardowymi licencjami z ograniczeniami użycia lub limitami komercyjnymi. Na przykład rodzina modeli Llama od Meta nakłada ograniczenia na organizacje powyżej określonych progów przychodowych. Zrozumienie licencji pod kątem konkretnego przypadku użycia, szczególnie w obszarze zastosowań komercyjnych i redystrybucji, jest niezbędne.
Poza licencjonowaniem odpowiedzialność za zgodność z przepisami spoczywa na tobie. Firmy muszą spełniać wymogi dotyczące prywatności danych, takie jak GDPR, oraz wymagania branżowe, takie jak HIPAA. To obejmuje praktyki minimalizacji danych, systemy filtrowania treści, fine-tuning z naciskiem na prywatność oraz ciągły monitoring i procesy audytowe.
Kolejną kwestią jest odpowiedzialność za wyniki modelu. Odpowiadasz za to, co generuje model, w tym za problemy z dokładnością, stronniczością, nieodpowiednimi treściami czy błędnymi poradami. Niezbędne stają się jasne warunki świadczenia usług, zastrzeżenia i procesy przeglądu przez człowieka.
Wyzwania związane z bezpieczeństwem
Modele open source niosą ze sobą specyficzne wyzwania związane z bezpieczeństwem, ponieważ wagi modeli i ich architektura są publiczne. Ta otwartość przyciąga zarówno współpracowników, jak i atakujących, którzy mogą analizować system pod kątem podatności.
Rygorystyczne środki bezpieczeństwa są niezbędne, w tym izolacja systemów zapobiegająca nieautoryzowanemu dostępowi, monitoring w czasie rzeczywistym pod kątem podejrzanej aktywności, protokoły bezpieczeństwa zgodne ze standardami enterprise oraz regularne audyty i aktualizacje bezpieczeństwa.
Obciążenia związane z bezpieczeństwem wykraczają poza sam model i obejmują cały stos infrastruktury — od przechowywania danych przez endpointy API po systemy monitorowania.
Co uwzględnić przy planowaniu LLM-ów open source
Te wyzwania nie są powodem, by unikać LLM-ów open source — to kwestie, które trzeba uwzględnić w planowaniu. Organizacje, które skutecznie wdrażają podejście open source, zwykle:
Zaczynają od jasno określonych przypadków użycia i mierników sukcesu
Rzetelnie oceniają wewnętrzne możliwości techniczne i budżet na wsparcie partnerów
Wyliczają rzeczywisty koszt utrzymania, uwzględniając także ukryte koszty
Wdrażają dokładne procesy testowania i zapewniania jakości
Planują iteracje i ciągłe doskonalenie
Budują lub pozyskują niezbędne kompetencje
LLM-y open source wiążą się z dodatkowymi wyzwaniami, dlatego trzeba ustalić, czy twoja organizacja ma odpowiedni przypadek użycia, skalę i możliwości, by przekuć te trudności w możliwe do opanowania szczegóły wdrożenia, oraz czy korzyści uzasadniają ten wysiłek.
Według stanu na połowę 2025 roku dla większości organizacji odpowiedź brzmi „nie”, a najpopularniejszym wyborem jest korzystanie z modeli OpenAI, Anthropic lub Google przez własnościowe API. Ale tysiące doświadczonych inżynierów nadal eksperymentują z LLM-ami open source i budują nowe, więc warto obserwować ten obszar. Trendy w branży AI zmieniają się szybko.
Jak wybrać między LLM-ami open source a własnościowymi
Gdy już wiesz, co oferują LLM-y open source, pozostaje praktyczne pytanie: kiedy wybrać je zamiast własnościowych alternatyw, takich jak GPT, Claude czy Gemini? Poniższa tabela podsumowuje kompromisy, a kolejne sekcje omawiają obie strony.
Czynnik | LLM-y open source | Własnościowe LLM-y |
|---|---|---|
Model kosztowy | Koszty infrastruktury i zespołu; przewidywalne, ale ponoszone głównie na początku | Rozliczenie za token; niski próg wejścia, koszt rośnie wraz z wolumenem |
Kontrola nad danymi | Mogą działać na własnej infrastrukturze; dane pozostają wewnątrz organizacji | Dane są wysyłane do zewnętrznego API |
Dostosowanie | Pełne dostrajanie i modyfikacja zachowania | Ograniczone do tego, co udostępnia API |
Wsparcie | Społeczność lub własny zespół; odpowiedzialność za rozwiązanie problemu jest po twojej stronie | Wsparcie dostawcy i SLA |
Czas wdrożenia | Dłuższy; wymagają konfiguracji, udostępnienia i monitorowania | Szybki; wystarczy wywołanie API |
Górna granica możliwości | Doganiają czołówkę, ale nadal ustępują w najtrudniejszych zadaniach wymagających rozumowania | Dziś przodują pod względem surowych możliwości |
Najlepsze w przypadku | danych regulowanych, głębokiego dostosowania i przewidywalnych budżetów przy dużej skali | szybkiego działania, prototypów i zespołów bez zaplecza ML engineering |
Kiedy wybrać modele własnościowe
Potrzebujesz od razu najnowocześniejszych możliwości. Własnościowe modele, takie jak GPT i Claude, przodują dziś pod względem surowych możliwości i wydajności, szczególnie w złożonych zadaniach wymagających rozumowania. Jeśli twoja aplikacja wymaga absolutnie najwyższej wydajności i nie możesz czekać, aż modele open source nadrobią dystans, opcje własnościowe to zapewniają.
Masz ograniczone zasoby techniczne. Własnościowe LLM-y oferują rozwiązania niemal gotowe do użycia, z prostą integracją przez API i platformy. Jeśli brakuje ci kompetencji z zakresu inżynierii ML i nie masz budżetu na wyspecjalizowanych konsultantów, prostota usług własnościowych jest atrakcyjna.
Kluczowe jest szybkie wdrożenie. W przypadku proof of conceptów lub MVP modele własnościowe pozwalają szybciej przejść do integracji i wdrożenia. Gdy priorytetem jest time-to-market, a skala użycia na początku jest niewielka, łatwiej korzystać z tych modeli przez API.
Kiedy wybrać modele open source
Dane nie mogą opuszczać twojego środowiska. Jeśli działasz w regulowanej branży i przetwarzasz dane wrażliwe (ochrona zdrowia, finanse, usługi prawne), modele open source wdrożone on-premises pozwalają zachować dane pod twoją kontrolą, bez udostępniania ich podmiotom trzecim.
Potrzebujesz zaawansowanej customizacji. Modele open source pozwalają dostrajać je na danych specyficznych dla danej dziedziny i zmieniać zachowanie modelu w sposób, na który własnościowe API po prostu nie pozwalają. Gdy ogólne możliwości nie wystarczają, ta elastyczność się opłaca.
Niezbędna jest przewidywalna struktura kosztów. Modele open source przenoszą koszty z rozliczeń opartych na użyciu na wydatki infrastrukturalne. Dla budżetowania i planowania finansowego taka przewidywalność może być cenna.
Masz odpowiednie zaplecze techniczne. Jeśli masz już inżynierów AI, kompetencje MLOps, albo budżet na wyspecjalizowanych partnerów, możesz skorzystać z zalet open source, nie tonąc w złożoności.
Hybrydowe podejście do LLM-ów
W złożonej rzeczywistości większości firm strategia hybrydowa często jest najlepszym wyborem. Korzystaj z modeli własnościowych tam, gdzie kluczowe są bezpieczeństwo, niezawodność i wsparcie, a z modeli open source tam, gdzie największe znaczenie mają customizacja i kontrola kosztów.
Typowe hybrydowe wzorce wykorzystania LLM-ów:
Modele własnościowe do zastosowań skierowanych do klientów, open source do zastosowań wewnętrznych: używaj modelu zamkniętego do interakcji z klientami, gdzie jakość jest najważniejsza, a modelu otwartego do narzędzi wewnętrznych i przetwarzania na dużą skalę.
Modele własnościowe do prototypowania, open source do produkcji: pracuj szybko z łatwymi w użyciu własnościowymi API, a potem migruj do samodzielnie hostowanych modeli open source, gdy skala użycia wzrośnie.
Modele własnościowe do zadań ogólnych, open source do specjalistycznych: używaj modeli własnościowych do szerokiego zakresu zastosowań, a modele open source dostrajaj pod specjalistyczną wiedzę domenową.
Kluczowe wnioski
Dla większości organizacji racjonalnym wyborem domyślnym jest dziś wiodący model zamknięty od OpenAI lub Anthropic; modele open source obsługują zaledwie około 13% obciążeń AI.
Open source wygrywa pod względem kontroli nad danymi, zaawansowanej customizacji i przewidywalnych kosztów przy dużej skali, dlatego sięgają po nie zespoły działające w regulowanych branżach i obsługujące duże wolumeny.
„Darmowe” to mit. Odpowiedź zależy od całkowitego kosztu utrzymania — od infrastruktury po wyspecjalizowany zespół — który, zależnie od skali, wynosi od około 125 000 USD do ponad 12 mln USD rocznie.
Nie ma jednego uniwersalnie „najlepszego” modelu. Dopasuj rozmiar i możliwości modelu do konkretnego zadania i testuj, zanim się zdecydujesz.
Konfiguracja hybrydowa — modele własnościowe tam, gdzie liczą się jakość i wsparcie, a open source tam, gdzie znaczenie mają customizacja i kontrola kosztów — to najczęstsza odpowiedź spotykana w praktyce.
Modele open source jako narzędzie strategiczne
Do wyboru jest tak wiele modeli open source, że łatwo się w tym pogubić, a ryzyko paraliżu analitycznego jest realne, więc podchodź do tego ostrożnie.
Dla większości organizacji racjonalnym wyborem jest dziś sięgnięcie po wiodący model zamknięty od OpenAI lub Anthropic. Jeśli jednak zdecydowałeś się korzystać z otwartych LLM-ów, oto co warto zrobić:
Określ konkretny przypadek użycia: jaki problem rozwiązujesz i jakie masz wymagania?
Dokładnie policz koszty: porównaj koszty użycia tokenów w modelu zamkniętym z kosztami infrastruktury, optymalizacji i utrzymania modelu otwartego.
Oceń swoje zaplecze techniczne: czy masz już odpowiednie kompetencje na pokładzie i czy eksperymentowanie z otwartymi LLM-ami jest u ciebie wykonalne?
Zacznij od małej skali i iteruj: zacznij od projektu pilotażowego, testuj na platformach takich jak Together.ai czy OpenRouter i zweryfikuj wybór modelu, zanim w pełni się zaangażujesz.
Bądź na bieżąco: śledź rozwój otwartych modeli, bo społeczność nadal wprowadza innowacje w imponującym tempie.
Otwarte LLM-y nie są dla każdego i nie są „darmowe”. To jedna z wielu opcji, które pozwalają wprowadzić możliwości LLM-ów do twoich produktów, systemów wewnętrznych czy codziennych procesów. Potraktuj ten wybór jak decyzję systemową: rozważ koszty, dane, możliwości i potencjał twojego zespołu w kontekście efektu, którego potrzebujesz, a przekonasz się, czy open source ma miejsce w twoim stosie technologicznym.
FAQ

Michał Nowakowski
Solution Architect and AI Expert at Monterail

Michał Nowakowski is a Solution Architect and AI Expert at Monterail. His strong data and automation foundation and background in operational business units give him a real-world understanding of company challenges. Michał leads feature discovery and business process design to surface hidden value and identify new verticals. He also advocates for AI-assisted development, skillfully integrating strict conditional logic with open-weight machine learning capabilities to build systems that reduce manual effort and unlock overlooked opportunities.