Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Data pipeline
Zautomatyzowany proces, który przenosi dane z miejsca ich powstania tam, gdzie są wykorzystywane, po drodze zmieniając ich formę.
Czym jest data pipeline?
Data pipeline to zautomatyzowana sekwencja kroków, która przenosi dane z systemów źródłowych do miejsca docelowego, gdzie można z nich korzystać, przekształcając je po drodze. Obejmuje ekstrakcję, walidację, transformację i ładowanie, a działa według harmonogramu albo w sposób ciągły, bez ręcznej ingerencji.
Taka potrzeba pojawia się dlatego, że dane powstają w jednej formie, a są wykorzystywane w innej. Baza danych aplikacji jest zaprojektowana pod szybki zapis pojedynczych rekordów. Zapytanie analityczne musi naraz agregować miliony rekordów z kilku systemów. Uruchomienie takiego zapytania na produkcyjnej bazie danych byłoby wolne i pogorszyłoby działanie aplikacji. To właśnie pipeline łączy te dwa światy.
Pipeline definiuje nie tylko logika, ale też niezawodność. Źródła danych przestają być dostępne, a schematy zmieniają się bez uprzedzenia. Rekordy przychodzą w nieprawidłowej postaci, a zadania kończą się awarią w połowie. Pipeline, który działa tylko wtedy, gdy wszystko przebiega bez zakłóceń, jest skryptem. Pipeline, który wykrywa błędy i można go uruchomić ponownie bez uszkodzenia danych docelowych, to już inżynieria.
Co data pipeline może dać mojej firmie?
Od tego, czy dane trafiają niezawodnie i w formie nadającej się do użycia, zależą zarówno dashboardy analityczne, jak i modele uczenia maszynowego. Tak samo jest z każdym raportem operacyjnym.
Przewaga strategiczna: To właśnie niezawodne pipeline'y umożliwiają podejmowanie decyzji na podstawie danych w skali całej organizacji. Bez nich analiza jest ręcznym procesem, który za każdym razem trzeba powtarzać od początku, więc wykonuje się ją rzadko i niespójnie. Dzięki nim te same liczby są stale dostępne dla wszystkich, a to odróżnia organizację, która przegląda wyniki raz na kwartał, od takiej, która reaguje co tydzień.
Problem, który rozwiązuje: Eliminuje ręczne składanie danych, które jest powolne i trudne do powtórzenia. Rozwiązuje też konflikt między obciążeniami operacyjnymi i analitycznymi, przenosząc analizę z systemów produkcyjnych na infrastrukturę zbudowaną właśnie do tego celu.
Jak działa data pipeline?
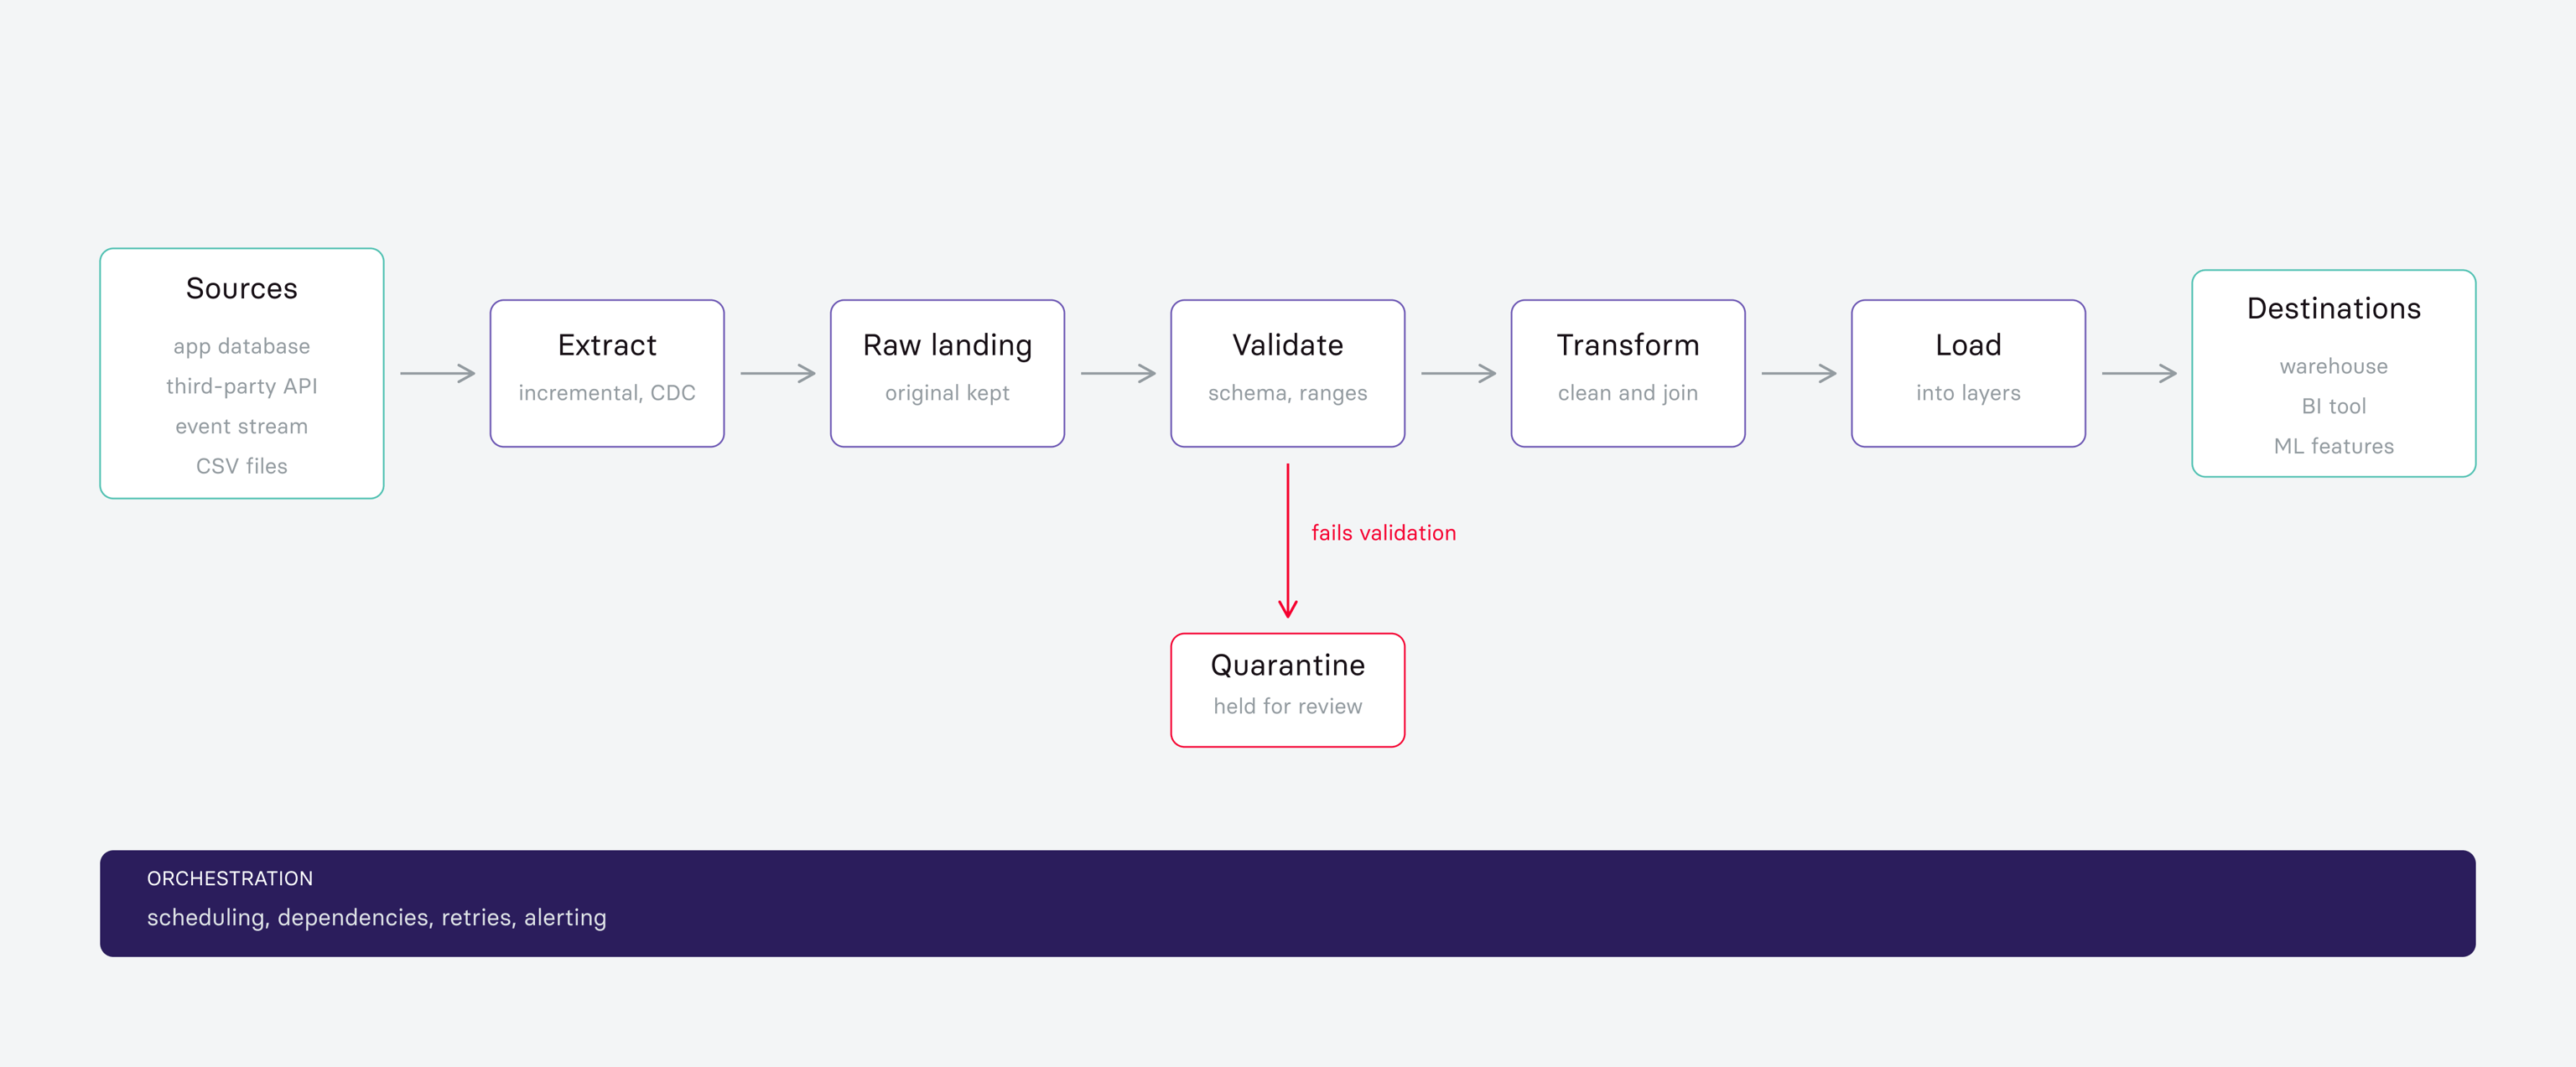
Pipeline to sekwencja etapów z określonym sposobem obsługi błędów, orkiestrwana tak, by zależności uruchamiały się we właściwej kolejności.
Ekstrakcja. Dane są pobierane ze źródeł: baz danych aplikacji, zewnętrznych API, strumieni zdarzeń, plików, platform SaaS. Standardem jest ekstrakcja przyrostowa, czyli pobieranie tylko rekordów zmienionych od poprzedniego uruchomienia, bo pełne przeładowania szybko stają się niepraktyczne wraz ze wzrostem wolumenu. Change data capture odczytuje bezpośrednio log transakcyjny bazy danych, dzięki czemu nie trzeba wykonywać zapytań na tabelach produkcyjnych.
Ingestia i warstwa lądowania. Surowe dane są zapisywane w magazynie w oryginalnej postaci, zanim przejdą jakąkolwiek transformację. Zachowanie tej surowej kopii ma znaczenie: jeśli błąd w transformacji zostanie wykryty po kilku miesiącach, oryginalne dane nadal są dostępne do ponownego przetworzenia.
Walidacja. Dane przychodzące są sprawdzane pod kątem oczekiwanego schematu, typu, zakresu, odsetka wartości null i wolumenu. Zmiany po stronie systemów upstream to najczęstsza przyczyna awarii pipeline'ów, a walidacja zamienia ciche uszkodzenie danych w wykryty błąd.
Transformacja. Dane są czyszczone, deduplikowane, łączone między źródłami i przekształcane w modele zaprojektowane pod zapytania. To tutaj znajduje się logika biznesowa: definicje przychodu, reguły segmentacji klientów, przeliczanie walut i uzgadnianie kalendarzy.
Ładowanie. Przekształcone dane są zapisywane w miejscu docelowym, takim jak hurtownia, lakehouse, indeks wyszukiwania czy feature store, i porządkowane warstwowo: od surowych, przez oczyszczone, po agregaty gotowe do wykorzystania biznesowego.
Orkiestracja. Harmonogram zarządza kolejnością wykonywania, zależnościami, ponowieniami i alertami. Nowoczesne orkiestratory śledzą nie tylko to, które zadania zostały uruchomione, ale też to, które zbiory danych są aktualne, dzięki czemu kolejne kroki czekają na poprawne wejście zamiast na określoną godzinę.
Monitoring i jakość danych. Pipeline'y monitorują nie tylko powodzenie zadań, ale też świeżość danych, liczbę wierszy, zmiany rozkładu i integralność referencyjną. Zadanie, które kończy się powodzeniem, ale nie ładuje żadnych danych, jest awarią, której alerty oparte wyłącznie na statusie sukcesu w ogóle nie wychwytują.
Jak wypada porównanie pipeline'ów wsadowych, strumieniowych i micro-batch?
Przetwarzanie wsadowe. Dane są przetwarzane w zaplanowanych grupach, zwykle co godzinę albo raz dziennie. Jest prostsze w budowie i łatwiejsze do zrozumienia, a przy tym w zupełności wystarcza do większości raportowania i analityki.
Przetwarzanie strumieniowe. Rekordy są przetwarzane na bieżąco, w ciągu sekund od nadejścia. Jest niezbędne przy wykrywaniu oszustw, personalizacji w czasie rzeczywistym i alertach operacyjnych, a jednocześnie znacznie trudniejsze do poprawnego zbudowania ze względu na zdarzenia przychodzące poza kolejnością i konieczność zarządzania stanem.
Micro-batch. Małe wsady uruchamiają się co kilka minut, zapewniając świeżość zbliżoną do czasu rzeczywistego przy zachowaniu dużej części prostoty przetwarzania wsadowego. To właściwy kompromis w wielu przypadkach, gdy zespoły na początku zakładają, że potrzebują streamingu.
Jaki stos technologiczny jest typowy dla data pipeline?
Orkiestracja: Apache Airflow, Dagster, Prefect, Mage.
Ekstrakcja i ładowanie: Fivetran, Airbyte, Stitch, Meltano w przypadku zarządzanych konektorów; Debezium do change data capture.
Transformacja: dbt jako dominujące narzędzie do transformacji opartych na SQL w hurtowni; Apache Spark do przetwarzania rozproszonego na dużą skalę; Polars i DuckDB do wydajnej pracy na pojedynczej maszynie.
Streaming: Apache Kafka, Apache Flink, Amazon Kinesis, Google Pub/Sub, Redpanda.
Miejsca docelowe przechowywania: Snowflake, BigQuery, Databricks, Amazon Redshift, ClickHouse; otwarte formaty tabel, w tym Apache Iceberg i Delta Lake.
Jakość danych: Great Expectations, Soda, testy dbt, Monte Carlo i Elementary do obserwowalności.
Katalog i lineage: DataHub, OpenMetadata, Atlan, Collibra.
Jakie są kluczowe cechy data pipeline?
Zautomatyzowany i działający według harmonogramu. Uruchamianie nie wymaga udziału człowieka, co umożliwia spójne i częste dostarczanie danych.
Idempotentny. Ponowne uruchomienie tego samego kroku daje ten sam rezultat bez duplikowania danych, dzięki czemu bezpiecznie można wrócić po częściowej awarii.
Walidowany na granicach etapów. Dane są sprawdzane przy wejściu i wyjściu z każdego etapu, więc zmiany upstream są wykrywane, zamiast trafiać dalej do raportów.
Z zachowaniem surowych danych. Oryginalny ekstrakt jest przechowywany, co umożliwia ponowne przetwarzanie po poprawieniu lub rozszerzeniu logiki transformacji.
Świadomy zależności. Kroki uruchamiają się we właściwej kolejności, a dalsze zadania czekają na poprawne wyniki etapów upstream.
Obserwowalny. Monitorowana jest świeżość i wolumen danych, ale także ich jakość, bo najbardziej szkodliwe awarie kończą się statusem sukcesu.
Wersjonowany. Logika pipeline'u znajduje się w repozytorium, przechodzi przegląd i testy, i jest traktowana jak oprogramowanie.
Jakie korzyści dają data pipeline?
Spójne liczby, którym można zaufać. Logika biznesowa jest definiowana w pipeline tylko raz, więc różne zespoły przestają dochodzić do innych wartości dla tej samej metryki.
Analiza bez wpływu na produkcję. Przeniesienie obciążeń analitycznych poza operacyjne bazy danych usuwa ryzyko, że ciężkie zapytanie pogorszy działanie aplikacji używanej przez klientów.
Dane dostępne wystarczająco szybko, by na ich podstawie działać. Automatyczne odświeżanie zastępuje ręczne składanie danych, zmieniając cykl raportowania z „gdy ktoś znajdzie czas” na ciągły.
Błędy wykrywane, zanim wpłyną na decyzje. Walidacja zatrzymuje nieprawidłowe lub niepełne dane na granicy systemu, zanim pojawią się jako niewytłumaczalna liczba w raporcie dla zarządu.
Wspólna podstawa dla uczenia maszynowego. Modele potrzebują wiarygodnych i odtwarzalnych danych cech. Ta sama infrastruktura pipeline'ów obsługuje zarówno analitykę, jak i uczenie maszynowe, co pozwala uniknąć równoległego budowania mechanizmów przepływu danych.
Czas analityków przeznaczony na analizę. Specjaliści od danych, którzy nie muszą ręcznie zbierać i czyścić danych, mogą skupić się na pytaniach, na które te dane miały odpowiedzieć.
Jakie wyzwania i kompromisy wiążą się z data pipeline?
Zmiany schematów upstream nieustannie psują pipeline'y. Systemy źródłowe zmieniają się bez informowania odbiorców downstream. Walidacja to wychwytuje, ale nic temu nie zapobiega, więc jest to stały koszt utrzymania, a nie problem, który da się raz na zawsze rozwiązać.
Ciche awarie są najgroźniejsze. Zadanie, które kończy się sukcesem mimo załadowania zera wierszy albo po cichu gubi rekordy, jest gorsze niż takie, które się wywraca, bo nikt tego nie sprawdza. Monitoring świeżości i wolumenu pozwala je wykryć.
Streaming jest znacznie trudniejszy, niż się wydaje. Zdarzenia przychodzące poza kolejnością, opóźnione nadejścia, semantyka exactly-once i zarządzanie stanem sprawiają, że pipeline'y strumieniowe są bardziej złożone w budowie i utrzymaniu. Wiele zespołów wdraża streaming, a potem odkrywa, że rzeczywiste wymagania spełniłby micro-batch.
Logika transformacji gromadzi nieudokumentowaną złożoność. Reguły biznesowe zaszyte w dziesiątkach kroków transformacji stają się trudne do zrozumienia i zmiany, zwłaszcza gdy osób, które je stworzyły, nie ma już w zespole.
Koszt rośnie wraz z nieefektywnością. Hurtownie chmurowe rozliczają moc obliczeniową, więc źle napisane transformacje i niepotrzebnie częste pełne odświeżenia generują wysokie rachunki. Przetwarzanie przyrostowe to decyzja kosztowa w takim samym stopniu, jak wydajnościowa.
Ponowne przetwarzanie historii jest kosztowne. Poprawienie błędu w transformacji oznacza ponowne uruchomienie jej na danych historycznych, co przy dużych zbiorach jest wolne i drogie. Zachowanie warstwy surowej w ogóle to umożliwia.
Kiedy użyć ETL zamiast ELT?
Czynnik | ETL | ELT |
Kolejność operacji | Transformacja przed ładowaniem | Najpierw ładowanie surowych danych, potem transformacja na miejscu |
Gdzie działa transformacja | Osobna warstwa przetwarzania | Docelowa hurtownia |
Dostępność surowych danych | Zwykle odrzucane | Zachowywane do ponownego przetwarzania |
Ponowne przetwarzanie historii | Wymaga ponownej ekstrakcji | Ponowne uruchomienie transformacji na zapisanych surowych danych |
Najlepiej sprawdza się przy | Ograniczonych systemach docelowych, filtrowaniu przed załadowaniem | Hurtowniach chmurowych z elastyczną mocą obliczeniową |
Obecna popularność | Legacy i szczególne przypadki | Domyślne nowoczesne podejście |
FAQ o data pipeline
Data pipeline: potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
EXPLORE WEB DEVELOPMENT SERVICESEXPLORE WEB DEVELOPMENT SERVICES