Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Retrieval-Augmented Generation (RAG)
Metoda, w której model językowy otrzymuje odpowiednie dokumenty w chwili zadania pytania i na ich podstawie udziela odpowiedzi.
Czym jest Retrieval-Augmented Generation?
Retrieval-augmented generation to technika, która łączy model językowy z zewnętrznym źródłem informacji. Gdy pojawia się pytanie, system przeszukuje zbiór dokumentów w poszukiwaniu odpowiednich fragmentów, a następnie przekazuje je modelowi razem z pytaniem i instrukcją, by odpowiedział na podstawie tych materiałów.
Problem, który rozwiązuje RAG, jest prosty. Model językowy wie tylko to, co znalazło się w danych treningowych, a te mają określoną datę graniczną i nie zawierają żadnych wewnętrznych informacji organizacji. Zapytany o politykę zwrotów firmy albo wyniki z ostatniego kwartału model bez dostępu do tych dokumentów albo odmówi odpowiedzi, albo poda coś, co brzmi wiarygodnie, ale zostało zmyślone.
RAG zmienia zadanie z odtwarzania wiedzy na rozumienie tekstu. System najpierw znajduje odpowiednie fragmenty, a potem prosi model o odpowiedź na ich podstawie. Dzięki temu odpowiedzi są aktualne i oparte na konkretnych źródłach. Model może też wskazać, skąd pochodzi każde twierdzenie, więc użytkownicy mogą zweryfikować wynik.
Co Retrieval-Augmented Generation może dać mojej firmie?
RAG to standardowa metoda wykorzystywania modeli językowych do pracy na informacjach zastrzeżonych, czyli tam, gdzie powstaje większość wartości komercyjnej.
Przewaga strategiczna: Pozwala korzystać z dokumentacji zgromadzonej w organizacji przez interfejs pytań i odpowiedzi: baz wiedzy działu wsparcia, dokumentacji inżynierskiej, polityk, umów czy archiwów badawczych. Te informacje już są w twojej firmie; RAG sprawia, że stają się dostępne, nawet jeśli nikt nie wie, który dokument otworzyć. Ponieważ mechanizm wyszukiwania działa na aktualnym indeksie, aktualizacja wiedzy systemu polega na zaktualizowaniu dokumentu, a nie na ponownym trenowaniu modelu.
Jaki problem rozwiązuje: Znacząco ogranicza konfabulacje, które są główną przeszkodą we wdrażaniu modeli językowych tam, gdzie błędne odpowiedzi mają realne konsekwencje. Oparcie odpowiedzi na odnalezionych fragmentach, wraz z cytowaniami, które użytkownik może sprawdzić, zmienia odpowiedź nie do zweryfikowania w odpowiedź, którą da się sprawdzić.
Jak działa Retrieval-Augmented Generation?
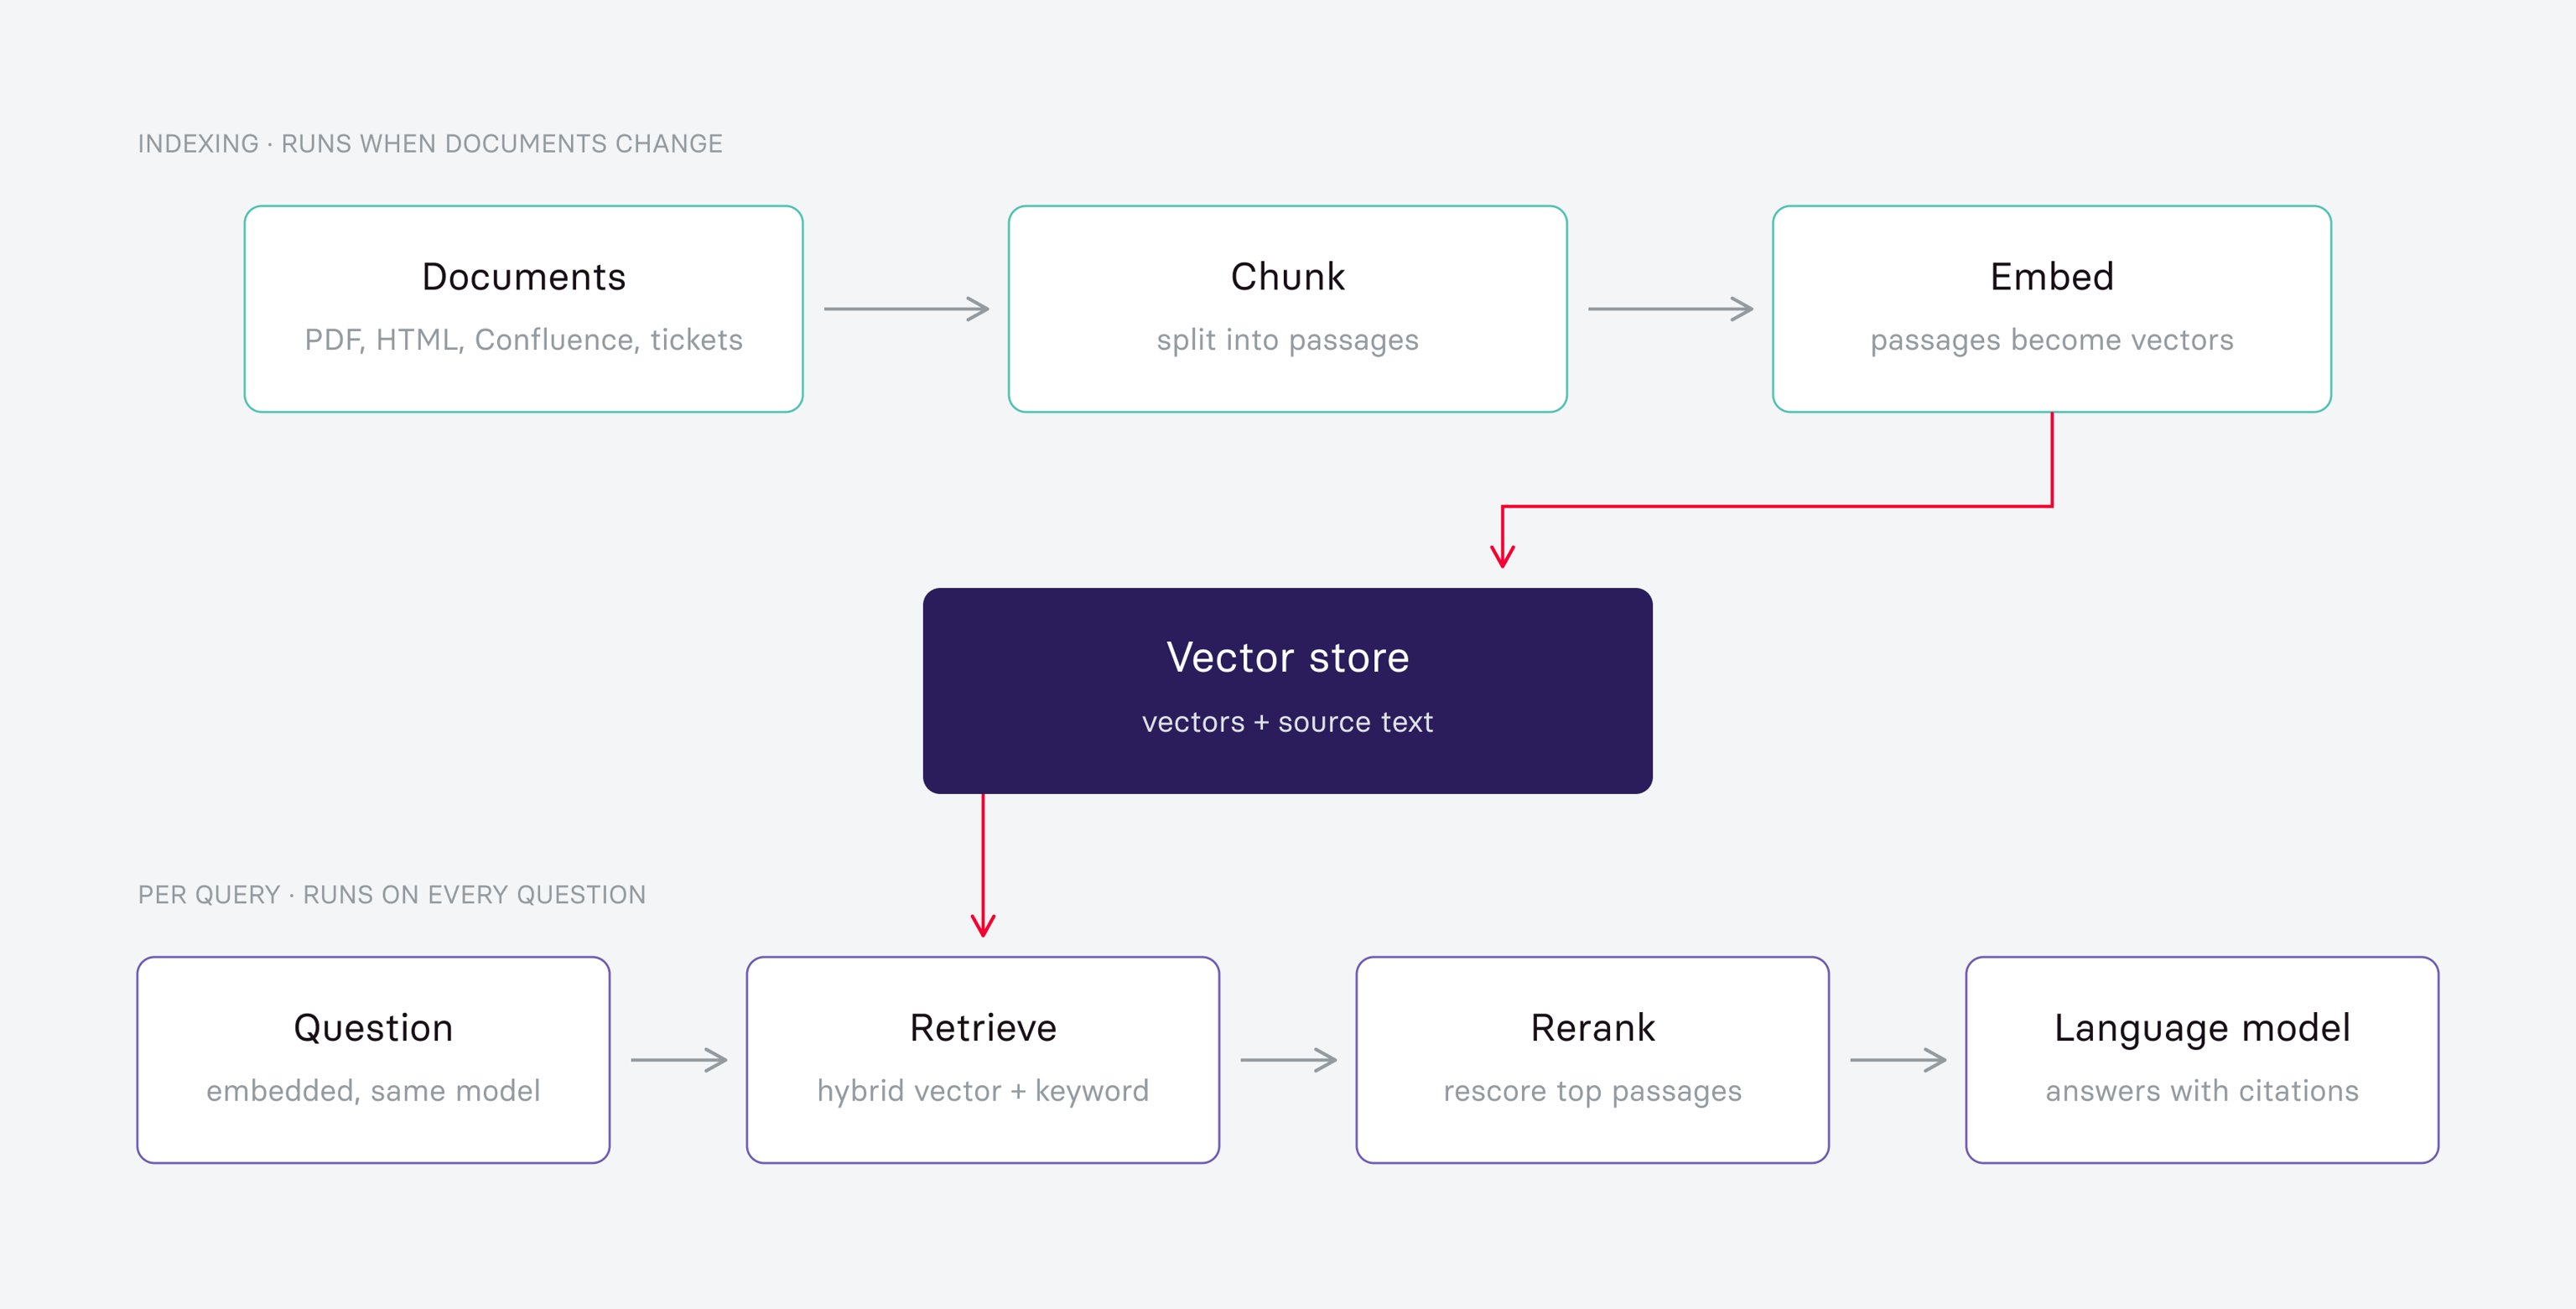
RAG ma dwie fazy: indeksowanie, które uruchamia się, gdy dokumenty się zmieniają, oraz wyszukiwanie i generowanie, które odbywa się przy każdym zapytaniu.
Indeksowanie (offline):
Pobieranie i parsowanie. Treść dokumentów jest wyodrębniana z ich formatów źródłowych: PDF, HTML, Word, Confluence czy systemów ticketowych. Jakość parsowania ma większe znaczenie, niż większość zespołów zakłada, bo tabele, układy wielokolumnowe i skanowane strony często są źródłem problemów.
Chunking. Dokumenty dzieli się na fragmenty na tyle małe, by były precyzyjne, ale na tyle duże, by zachować znaczenie, zwykle od 200 do 800 tokenów z pewnym nakładaniem się. Dzielenie tekstu w środku wyjaśnienia to jedna z najczęstszych przyczyn słabej jakości wyszukiwania.
Embedding. Każdy fragment jest zamieniany na wektor opisujący jego znaczenie za pomocą modelu embeddingowego.
Przechowywanie. Wektory i odpowiadający im tekst źródłowy są zapisywane w vector store, czyli bazie wektorowej albo wyszukiwarce obsługującej zapytania wektorowe, razem z metadanymi, takimi jak źródło, data, autor i uprawnienia dostępu.
Wyszukiwanie i generowanie (dla każdego zapytania):
Przetwarzanie zapytania. Pytanie jest osadzane przy użyciu tego samego modelu i może zostać przepisane tak, by poprawić wyszukiwanie: przez rozwinięcie skrótów, rozstrzygnięcie odwołań do wcześniejszych wypowiedzi w rozmowie albo podział pytania złożonego.
Wyszukiwanie. System znajduje fragmenty, których wektory są najbliższe wektorowi zapytania. Systemy produkcyjne zwykle łączą to z wyszukiwaniem słów kluczowych, bo wyszukiwanie wektorowe dobrze radzi sobie z parafrazami, ale pomija dokładne identyfikatory, kody produktów i rzadkie terminy.
Reranking. Model cross-encoder ponownie ocenia najlepszych kandydatów względem zapytania dokładniej, niż pozwala na to wstępne wyszukiwanie. Ten krok w przewidywalny sposób poprawia jakość i często daje największą wartość dodaną w podstawowej implementacji.
Budowa promptu. Najtrafniejsze fragmenty trafiają do promptu razem z pytaniem oraz instrukcjami, by odpowiadać wyłącznie na podstawie dostarczonych materiałów, cytować źródła i jasno zaznaczać, kiedy materiał nie zawiera odpowiedzi.
Generowanie i cytowanie. Model tworzy odpowiedź z odwołaniami do wykorzystanych fragmentów, tak by użytkownik mógł zweryfikować twierdzenia w oryginalnych dokumentach.
Jakich narzędzi używa się do budowy RAG?
Bazy wektorowe: Pinecone, Weaviate, Qdrant, Milvus, Chroma oraz pgvector dla zespołów, które już korzystają z PostgreSQL.
Wyszukiwanie hybrydowe: Elasticsearch i OpenSearch, łączące ocenę słów kluczowych BM25 z podobieństwem wektorowym.
Modele embeddingowe: Cohere Embed, modele text-embedding od OpenAI oraz otwarte alternatywy, w tym BGE i E5.
Reranking: Cohere Rerank oraz otwarte modele cross-encoder z rodziny Sentence Transformers.
Orkiestracja: LangChain, LlamaIndex, Haystack albo implementacja bezpośrednia, którą wiele zespołów wybiera w środowiskach produkcyjnych, bo frameworki wprowadzają dodatkową warstwę abstrakcji utrudniającą debugowanie.
Modele generujące: Claude, GPT, Gemini oraz otwarte modele, takie jak Llama i Mistral, używane bezpośrednio albo przez Bedrock, Vertex AI lub Azure AI Foundry.
Ewaluacja: RAGAS, TruLens oraz własne zestawy testowe pytań ze znanymi poprawnymi odpowiedziami i wskazanymi dokumentami źródłowymi.
Jakie są najważniejsze cechy Retrieval-Augmented Generation?
Wiedza znajduje się poza modelem. Aktualizacja tego, co system „wie”, oznacza zmianę dokumentów i ponowne indeksowanie, co zajmuje minuty zamiast dni lub tygodni potrzebnych na pełny cykl ponownego trenowania.
Odpowiedzi można prześledzić do źródeł. Każda odpowiedź może zawierać cytowania wykorzystanych fragmentów, dzięki czemu użytkownicy mogą zweryfikować twierdzenia, a audytorzy mają zapis tego, co stanowiło podstawę odpowiedzi.
Jakość wyszukiwania wyznacza górny limit. Jeśli poprawny fragment nie zostanie odnaleziony, żaden model nie wygeneruje poprawnej odpowiedzi opartej na źródłach. Większość porażek RAG to porażki wyszukiwania.
Kontrolę dostępu da się egzekwować na etapie wyszukiwania. Ponieważ wyszukiwanie jest filtrowanym zapytaniem, uprawnienia można stosować dla każdego użytkownika osobno, tak by każdy otrzymywał odpowiedzi wyłącznie z dokumentów, do których ma prawo dostępu.
Decyzje dotyczące chunkingu i parsowania mają nieproporcjonalnie duży wpływ. To, jak dzielisz dokumenty i jak wiernie wyodrębniasz je z oryginalnych formatów, wpływa na jakość końcowych odpowiedzi bardziej niż wybór modelu generującego.
Ogranicza konfabulacje, ale ich nie eliminuje. Model nadal może błędnie połączyć dwa źródła albo uzupełnić lukę zmyśloną treścią. Pomagają instrukcje, by wstrzymać się od odpowiedzi, gdy materiał jest niewystarczający, ale ewaluacja nadal jest konieczna.
Jakie korzyści daje Retrieval-Augmented Generation?
Aktualne informacje bez ponownego trenowania. System odzwierciedla stan dzisiejszych dokumentów. Zmiana polityki opublikowana dziś rano jest od razu dostępna, czego żaden model fine-tuned nie potrafi zapewnić.
Odpowiedzi, które można zweryfikować. Cytowania pozwalają sprawdzić źródło, a to właśnie sprawia, że wynik nadaje się do użycia w obszarach wsparcia, prawa i medycyny.
Niższy koszt niż fine-tuning. Zbudowanie indeksu kosztuje ułamek tego, co fine-tuning modelu, a jego utrzymanie jest znacznie tańsze niż powtarzanie cykli treningowych przy każdej zmianie informacji.
Odpowiedzi uwzględniające uprawnienia. Wyszukiwanie filtrowane zgodnie z uprawnieniami użytkownika oznacza, że jeden system może obsługiwać całą organizację bez ujawniania materiałów o ograniczonym dostępie między zespołami.
Mniejsze pole do halucynacji. Ograniczenie modelu do dostarczonych fragmentów i instrukcja, by w innych przypadkach wstrzymał się od odpowiedzi, usuwa dużą część przestrzeni, w której powstają konfabulacje.
Jakie wyzwania i kompromisy wiążą się z RAG?
Dominującym trybem awarii jest nieudane wyszukiwanie. Wyszukiwanie wektorowe pomija dokładne identyfikatory i rzadkie terminy; wyszukiwanie po słowach kluczowych pomija parafrazy. Systemy oparte wyłącznie na jednym z tych podejść wypadają zauważalnie gorzej niż podejścia hybrydowe.
Parsowanie dokumentów jest trudniejsze, niż się wydaje. Tabele, skanowane PDF-y, układy wielokolumnowe i diagramy regularnie prowadzą do zniekształconego tekstu, którego żaden dalszy komponent nie jest w stanie naprawić.
Chunking wymaga dostrojenia do każdego korpusu. Zbyt małe fragmenty tracą kontekst; zbyt duże osłabiają trafność i zużywają okno kontekstowe. Nie ma jednego ustawienia, które dobrze działa dla wszystkich typów dokumentów.
Opóźnienia kumulują się w całym pipeline. Embedding, wyszukiwanie, reranking i generowanie każde dokładają czas, a naiwna implementacja może zajmować kilka sekund na jedno zapytanie, co w interfejsie konwersacyjnym jest odczuwalne.
Ewaluacja jest trudna. Ocena, czy odpowiedź jest poprawna, kompletna i właściwie oparta na źródłach, wymaga przygotowanego zestawu testowego ze znanymi odpowiedziami. Zespoły, które to pomijają, nie są w stanie stwierdzić, czy zmiany poprawiają system, czy go pogarszają.
Sprzeczne źródła prowadzą do błędnych odpowiedzi. Gdy korpus zawiera nieaktualną politykę i jej nowszą wersję, wyszukiwanie może zwrócić obie, a model nie ma wiarygodnego sposobu, by ustalić, która zastępuje drugą. Potrzebne są metadane i dbałość o porządek w indeksie.
Uprawnienia muszą być stosowane na etapie wyszukiwania. Filtrowanie wyników po wygenerowaniu odpowiedzi jest niebezpieczne, bo treści o ograniczonym dostępie mogły już wpłynąć na jej treść.
Czy wybrać RAG czy fine-tuning?
Czynnik | RAG | Fine-tuning |
Co się zmienia | Informacje dostępne w momencie zapytania | Wagi modelu i jego zachowanie |
Aktualizacja wiedzy | Ponowne indeksowanie dokumentów; minuty | Ponowne trenowanie; od kilku dni do kilku tygodni |
Przypisanie do źródła | Dostępne cytowania | Brak |
Koszt wdrożenia | Umiarkowany; pipeline indeksowania | Wyższy; oznaczone dane i moc obliczeniowa |
Najlepsze zastosowanie | Pytania o fakty dotyczące zmieniających się dokumentów | Spójny ton, format albo sposób wykonywania zadania |
Kontrola dostępu | Możliwa do wyegzekwowania dla każdego użytkownika na etapie wyszukiwania | Niemożliwa; wiedza jest wbudowana w model |
FAQ o Retrieval-Augmented Generation
Powiązane pojęcia
Retrieval-Augmented Generation (RAG): potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
POZNAJ USŁUGI AIPOZNAJ USŁUGI AI