Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Graf wiedzy
Baza danych zaprojektowana tak, by relacje były przechowywane i wyszukiwane bezpośrednio, zamiast być składane z oddzielnych rekordów.
Czym jest graf wiedzy?
Graf wiedzy przechowuje informacje jako sieć encji i relacji między nimi. Każda encja, na przykład produkt lub firma, jest węzłem, a każda relacja to opisana etykietą krawędź, dzięki czemu same połączenia stają się danymi, które można odpytywać.
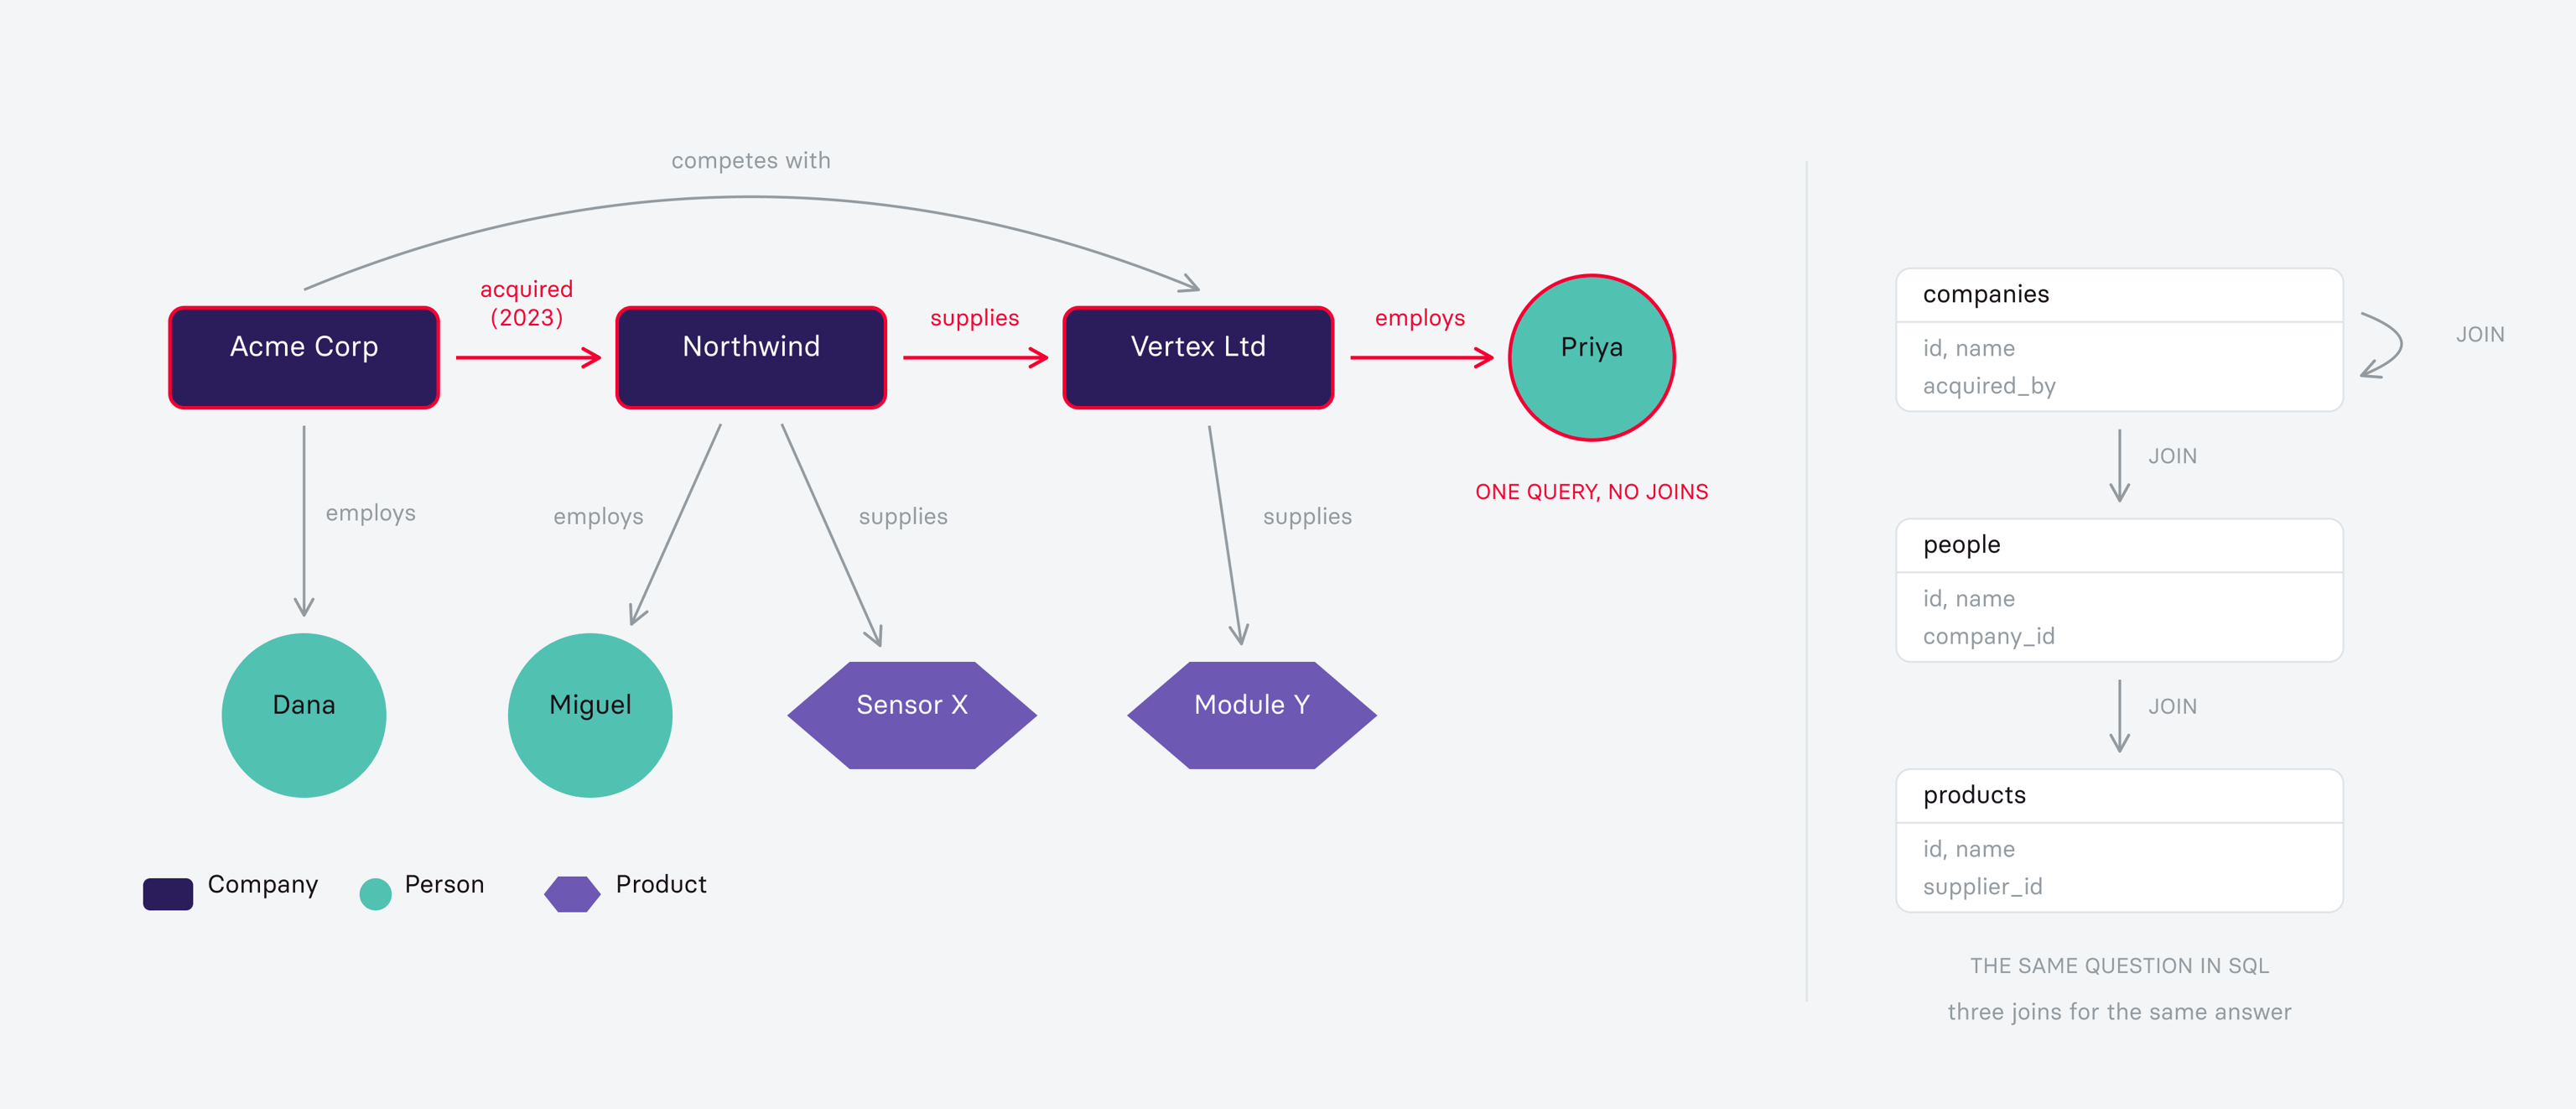
Różnica względem relacyjnej bazy danych sprowadza się do tego, gdzie zapisane są relacje. W modelu relacyjnym powiązanie między klientem a zamówieniem istnieje jako klucz obcy i jest odkrywane przez łączenie tabel. W grafie relacja jest zapisana wprost, ma określony typ i może mieć własne właściwości: na przykład „przejęcie”, wraz z datą i wartością transakcji.
Ma to znaczenie przy pytaniach, które wymagają przejścia przez wiele połączeń. Ustalenie, którzy dostawcy są pośrednio dotknięci zamknięciem fabryki oddalonym o cztery ogniwa w łańcuchu dostaw, wymaga w SQL czterech złączeń, a koszt rośnie gwałtownie wraz z głębokością. Grafowa baza danych podąża bezpośrednio po zapisanych połączeniach, więc koszt takiego przechodzenia zależy od liczby faktycznie przebytej relacji, a nie od całkowitego rozmiaru tabel.
Czy graf wiedzy sprawdzi się w mojej firmie?
Większość organizacji ma dane, których wartość wynika z ich powiązań, a same dane są rozproszone po systemach zapisujących tylko własny fragment całości.
Przewaga strategiczna: Graf wiedzy daje jeden spójny, połączony obraz danych z wcześniej odseparowanych źródeł. W praktyce wspiera to możliwości, które trudno zbudować inaczej: rekomendacje oparte na relacjach wieloetapowych oraz wykrywanie nadużyć dzięki strukturze pierścieni, w której każdy rekord z osobna wygląda wiarygodnie. Na tej samej właściwości opierają się analiza ryzyka w łańcuchu dostaw i badania nad odkrywaniem leków. Wartość konkurencyjna tkwi w starannie opracowanych relacjach, których odtworzenie jest dla konkurencji kosztowne.
Jaki problem rozwiązuje: Pozwala odpowiadać na pytania wykraczające poza granice systemów i obejmujące wiele poziomów relacji. „Którzy z naszych klientów klasy enterprise mają tę samą spółkę matkę co klient, który odszedł w poprzednim kwartale, i którzy z naszych pracowników współpracowali z obiema stronami?” wymaga danych połączonych relacjami. Tradycyjne hurtownie danych dobrze odpowiadają na pytania agregacyjne, ale słabo radzą sobie z pytaniami o powiązania.
Jak działa graf wiedzy?
Graf wiedzy łączy model danych z magazynem zoptymalizowanym pod kątem przechodzenia po relacjach oraz procesem, który utrzymuje go na bieżąco.
Definiowanie ontologii. Schemat określa, jakie typy encji istnieją, jakie relacje są dozwolone i jakie właściwości ma każda z nich. To modelowanie przesądza o tym, na jakie pytania graf będzie w stanie odpowiedzieć, i właśnie na tym etapie koncentruje się większość pracy koncepcyjnej.
Ekstrakcja i import encji. Dane napływają z baz danych, API i dokumentów. Źródła ustrukturyzowane mapują się dość bezpośrednio. Tekst nieustrukturyzowany wymaga NLP do identyfikacji encji i relacji, które są w nim stwierdzane, a coraz częściej ekstrakcję wykonują modele językowe.
Uzgadnianie encji. Rekordy odnoszące się do tego samego obiektu w świecie rzeczywistym trzeba scalić. „IBM”, „International Business Machines” i „I.B.M.” to jedna firma, a niezawodne rozstrzyganie takich przypadków wśród milionów rekordów jest zwykle najtrudniejszą częścią budowy grafu wiedzy.
Zapisywanie danych jako węzłów i krawędzi. Dane trafiają do grafowej bazy danych, w której każda relacja jest bezpośrednim wskaźnikiem między węzłami, co właśnie sprawia, że przechodzenie po grafie jest szybkie niezależnie od wielkości całego zbioru danych.
Odpytywanie przez przechodzenie po relacjach. Zapytania opisują wzorce do dopasowania: znajdź wszystkie ścieżki z tego węzła do dowolnego węzła tego typu w obrębie trzech przeskoków, gdzie relacje spełniają podane warunki. Języki zapytań do grafów, takie jak Cypher, Gremlin i SPARQL, opierają się właśnie na tym modelu dopasowywania wzorców.
Wnioskowanie na podstawie zapisanych faktów. Niektóre systemy grafowe wyprowadzają nowe fakty z już istniejących za pomocą reguł, na przykład jeśli A jest spółką zależną B, a B spółką zależną C, to A jest pośrednio kontrolowana przez C, co zmniejsza zakres informacji, które trzeba zapisać wprost.
Utrzymanie i jakość. Grafy pogarszają się wraz ze zmianami w źródłach i narastaniem błędów ekstrakcji. Ciągła walidacja i uzgadnianie są częścią utrzymania grafu w działaniu.
Jakich narzędzi używa się do budowy grafów wiedzy?
Grafowe bazy danych: Neo4j, Amazon Neptune, TigerGraph, ArangoDB, Memgraph; Apache Jena i GraphDB w podejściach opartych na RDF.
Języki zapytań: Cypher, obecnie standaryzowany jako GQL; Gremlin dla Apache TinkerPop; SPARQL dla grafów RDF.
Standardy dla grafów semantycznych: RDF, OWL i SHACL do opisywania ontologii oraz walidacji zgodności.
Ekstrakcja i uzgadnianie: spaCy i modele Hugging Face do rozpoznawania encji, duże modele językowe do ekstrakcji relacji, Dedupe i Zingg albo komercyjne narzędzia do master data management do uzgadniania encji.
Publiczne i referencyjne grafy: Wikidata, DBpedia oraz zasoby dziedzinowe, takie jak UMLS i SNOMED CT w ochronie zdrowia.
Analityka: biblioteki algorytmów grafowych do analizy centralności, wykrywania społeczności i najkrótszej ścieżki, dostępne w Neo4j Graph Data Science i narzędziach równoważnych.
Jakie są kluczowe cechy grafu wiedzy?
Relacje są pełnoprawnymi danymi. Połączenia mają typy i właściwości oraz można je odpytywać i filtrować tak samo jak encje.
Koszt przechodzenia jest lokalny. Podążanie po relacjach zależy od liczby przebywanych połączeń, dlatego pytania wieloetapowe pozostają szybkie nawet wtedy, gdy danych przybywa.
Schemat może ewoluować stopniowo. Nowe typy encji i relacji można dodawać bez przebudowy istniejących danych, co dobrze sprawdza się w obszarach, gdzie model dopiero się wyłania.
Różnorodne źródła są scalane. Dane z oddzielnych systemów są łączone przez wspólne encje, co daje jeden obraz całości bez wciskania wszystkiego w jedną sztywną strukturę tabel.
Semantyka jest jawna. Typy relacji bezpośrednio określają znaczenie. Klucz obcy zapisuje, że dwa wiersze są powiązane, a krawędź z etykietą „prescribed_for” mówi, jaki jest charakter tego powiązania.
Jakość zależy od uzgadniania encji. Graf jest tylko tak użyteczny, jak dobre jest to uzgadnianie. Zduplikowane encje rozbijają sieć i prowadzą do niepełnych odpowiedzi dokładnie na te pytania, do których graf został zbudowany.
Jakie korzyści dają grafy wiedzy?
Pytania wieloetapowe stają się praktyczne. Zapytania obejmujące kilka relacji działają wydajnie, podczas gdy ich odpowiedniki w SQL stają się wolne i trudne w utrzymaniu.
Połączony obraz danych z systemów silosowych. Encje występujące w kilku systemach są łączone raz, co daje spójny obraz bez pełnego programu konsolidacji hurtowni danych.
Lepsze rekomendacje i wyszukiwanie. Struktura relacji wspiera rekomendacje oparte na powiązaniach. Poprawia też wyszukiwanie, rozszerzając zapytania o pojęcia pokrewne.
Wykrywanie wzorców strukturalnych. Pierścienie nadużyć i cykliczna struktura własności stają się widoczne jako struktury grafowe, choć każdy rekord z osobna wygląda niepozornie.
Elastyczny rozwój modelu. Dodanie nowego typu relacji nie wymaga migracji istniejących danych, co pasuje do obszarów eksploracyjnych i badawczych.
Bardziej wiarygodna podstawa dla systemów AI. Połączenie grafu wiedzy z retrieval-augmented generation daje modelom językowym uporządkowane fakty i jawne relacje, poprawiając trafność odpowiedzi na pytania wymagające rozumowania opartego na powiązaniach.
Jakie wyzwania i kompromisy wiążą się z grafami wiedzy?
Uzgadnianie encji jest trudne. Dopasowywanie rekordów do rzeczywistych obiektów w niespójnych źródłach jest w większości projektów głównym składnikiem kosztu, a błędy przenoszą się na każde zapytanie.
Projektowanie ontologii wymaga wiedzy eksperckiej i iteracji. Zmiana źle zaprojektowanego schematu po jego zapełnieniu jest kosztowna, a poprawne przygotowanie wymaga zarówno znajomości domeny, jak i doświadczenia w modelowaniu.
Grafowe bazy danych są słabsze w analityce agregacyjnej. Hurtownie kolumnowe najlepiej radzą sobie ze zliczaniem i grupowaniem dużych wolumenów danych. Grafy dobrze odpowiadają na pytania o powiązania, ale relatywnie słabiej na pytania agregacyjne, dlatego większość organizacji korzysta z obu podejść.
Te kompetencje są rzadsze. Cypher, SPARQL i modelowanie grafów są mniej znane zespołom biegle posługującym się SQL, co wydłuża czas wdrożenia i zawęża pulę kandydatów do zatrudnienia.
Utrzymanie jest ciągłe. Źródła się zmieniają, a duplikaty narastają. Graf bez stałej pracy nad jakością degraduje się do momentu, w którym nie można już ufać jego odpowiedziom.
Skalowanie wymaga ostrożności. Bardzo duże grafy trudno partycjonować, bo relacje przecinające partycje osłabiają wydajność przechodzenia po grafie, dla której w ogóle go wybrano.
Wybrać bazę grafową czy SQL?
Czynnik | Graf wiedzy | Relacyjna baza danych |
Sposób przechowywania relacji | Jawne krawędzie z typami | Klucze obce rozwiązywane przez złączenia |
Zapytania wieloetapowe | Wydajne; koszt rośnie wraz ze ścieżką | Wydajność gwałtownie spada wraz z głębokością złączeń |
Analityka agregacyjna | Relatywnie słaba | Mocna |
Zmiana schematu | Stopniowa, niski koszt | Wymagana migracja |
Język zapytań | Cypher, Gremlin, SPARQL | SQL |
Najlepiej nadaje się do | Połączonych, ewoluujących i heterogenicznych danych | Ustrukturyzowanych transakcji i raportowania |
FAQ o grafach wiedzy
Powiązane pojęcia
Graf wiedzy: potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
POZNAJ USŁUGI AIPOZNAJ USŁUGI AI