Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
MLOps
Zbiór praktyk, które pomagają utrzymać trafność i niezawodność modelu uczenia maszynowego po wdrożeniu, gdy dane, na których się opiera, stale się zmieniają.
Czym jest MLOps?
MLOps obejmuje wszystko, co pozwala utrzymać model uczenia maszynowego w działaniu po jego wdrożeniu. Bazuje na DevOps, który zakłada, że zachowanie systemu wynika z kodu. W uczeniu maszynowym to założenie się nie sprawdza: zachowanie modelu zależy od danych treningowych, więc one także muszą być wersjonowane, a trafność spada wraz ze zmianą warunków, nawet jeśli żaden test nie zwróci błędu.
Zwykłe oprogramowanie działa deterministycznie. Dla tych samych danych wejściowych daje te same wyniki, a zaliczony zestaw testów potwierdza, że wszystko działa poprawnie. Uczenie maszynowe podważa oba te założenia. Zachowanie modelu określają dane, na których został wytrenowany, więc odtworzenie wyniku wymaga dokładnie tych samych danych i tego samego kodu, łącznie z konfiguracją. A model, który w marcu był trafny, we wrześniu może już się mylić, bo zmienił się świat, choć system nie zgłosi żadnego błędu i żaden test niczego nie wykryje.
MLOps istnieje właśnie dlatego, że te różnice sprawiają, iż standardowe praktyki wdrożeniowe nie wystarczają. Ta dziedzina zakłada wersjonowanie danych razem z modelami i automatyzuje ponowne trenowanie. Nowe wersje są wdrażane stopniowo i pozostają pod stałym monitoringiem.
Czy warto inwestować w MLOps?
Wytrenowany model z dobrymi wynikami testów ma wartość biznesową tylko wtedy, gdy niezawodnie wspiera podejmowanie decyzji. Różnica między dobrym modelem a modelem, który rzeczywiście działa, zwykle sprowadza się do zdolności wdrożeniowych i utrzymaniowych.
Przewaga strategiczna: MLOps zamienia modele z efektów badań w realne zasoby operacyjne. Zespoły z dojrzałym podejściem wdrażają usprawnienia modeli w ciągu kilku dni, bo ponowne trenowanie i wdrożenie odbywają się bez ręcznych kroków. Ten krótszy cykl z czasem daje coraz większą przewagę: zespół, który iteruje co tydzień, rozwija się szybciej niż taki, który ponownie wdraża model dwa razy w roku.
Jaki problem to rozwiązuje: Chodzi o ciche awarie. Model bez monitoringu może stopniowo tracić jakość, nie alarmując nikogo, więc model wykrywania nadużyć, który przestaje rozpoznawać nowe schematy oszustw, albo prognoza popytu, która traci kalibrację, mogą generować straty narastające, zanim ktokolwiek powiąże je z modelem. Monitoring i planowane ponowne trenowanie zamieniają to ukryte ryzyko w proces, którym można zarządzać.
Jak działa MLOps?
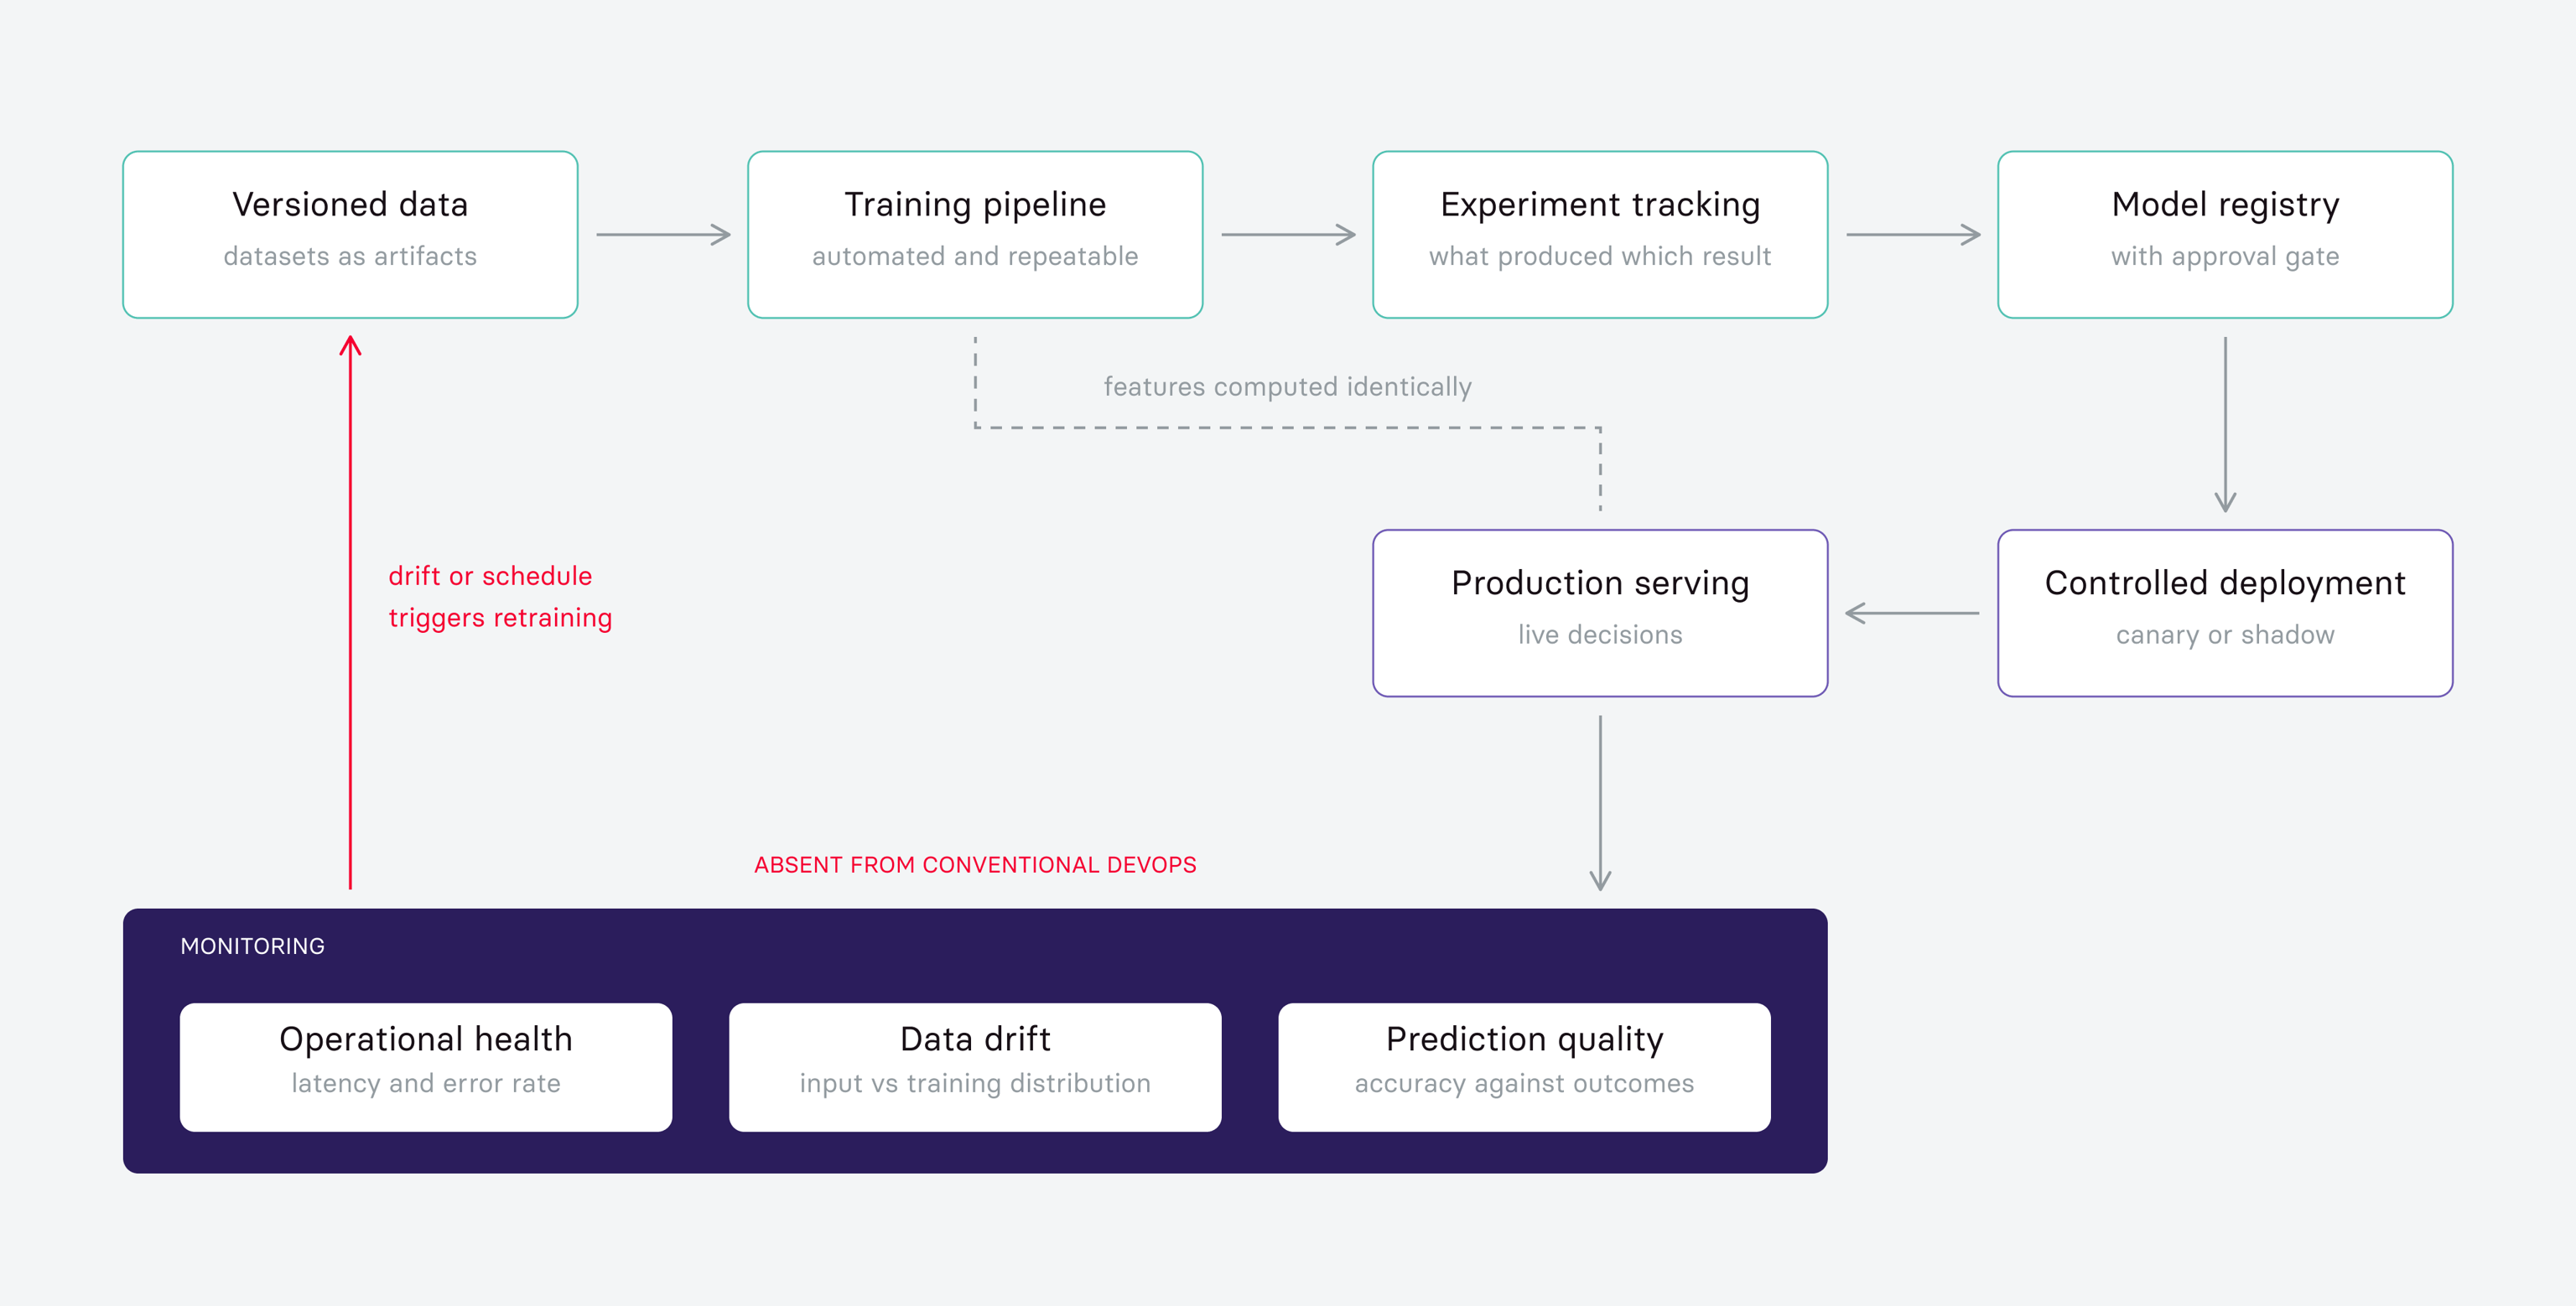
MLOps opiera się na pipeline'ie obejmującym całą drogę od danych do monitorowanego modelu działającego na produkcji, z automatyzacją na każdym etapie.
Wersjonowanie i walidacja danych. Zbiory danych treningowych są wersjonowane, aby każdy model można było dokładnie odtworzyć. Napływające dane są automatycznie walidowane pod kątem oczekiwanego schematu i zakresów wartości, ponieważ zmiany w źródłach upstream to najczęstsza przyczyna awarii modeli na produkcji.
Śledzenie eksperymentów. Każdy przebieg treningu zapisuje dokładne dane i kod, z których korzystał, wraz z hiperparametrami i wynikami. Bez tego zespoły nie są w stanie wiarygodnie ustalić, która konfiguracja dała najlepszy model, ani odtworzyć jej później.
Zautomatyzowane pipeline'y treningowe. Trenowanie odbywa się w skryptowanym, powtarzalnym pipeline'ie, co właśnie sprawia, że ponowne trenowanie staje się rutyną.
Rejestr modeli. Wytrenowane modele są przechowywane wraz z pełną historią pochodzenia, statusem akceptacji i metrykami, na podstawie których zostały ocenione. Dzięki temu przejście od kandydata do produkcji odbywa się w kontrolowany sposób, a zespół ma zapis tego, co i kiedy zostało wdrożone.
Spójność cech między trenowaniem a serwowaniem modelu. Cechy muszą być obliczane identycznie w obu tych kontekstach. Rozjazd między trenowaniem a produkcją, czyli sytuacja, w której cecha jest liczona w jeden sposób podczas treningu, a inaczej na produkcji, to częste i trudne do zdiagnozowania źródło spadku trafności. Właśnie temu mają zapobiegać feature store'y.
Kontrolowane wdrożenie. Nowe wersje modeli trafiają na produkcję przez shadow deployment albo canary release, a nie przez bezpośrednie zastąpienie poprzedniej wersji, dzięki czemu można obserwować ich zachowanie w rzeczywistych warunkach, zanim przejmą cały ruch.
Monitoring produkcyjny. Obserwuje się trzy odrębne obszary: stan operacyjny systemu (opóźnienia i wskaźnik błędów), drift danych (czy dane wejściowe nadal przypominają rozkład danych treningowych) oraz jakość predykcji (trafność względem rzeczywistych wyników, gdy te stają się już znane).
Ponowne trenowanie i rollback. Ponowne trenowanie uruchamia harmonogram albo wykrycie driftu, a przed promocją model przechodzi przez zautomatyzowane bramki walidacyjne. Powrót do poprzedniej wersji modelu musi być natychmiastowy, ponieważ błędne wdrożenie modelu może wyrządzić więcej szkód niż błędne wdrożenie kodu.
Jakich narzędzi używa się w MLOps?
Śledzenie eksperymentów i rejestr modeli: MLflow, Weights & Biases, Neptune.
Orkiestracja pipeline'ów: Kubeflow Pipelines, Metaflow, Airflow, Prefect, Dagster.
Wersjonowanie danych i modeli: DVC, LakeFS, Delta Lake.
Feature store'y: Feast, Tecton oraz komponenty feature store dostępne w Vertex AI i SageMaker.
Serwowanie modeli: BentoML, Seldon Core, KServe, TorchServe, NVIDIA Triton.
Monitoring: Evidently, WhyLabs, Arize, Fiddler do monitorowania driftu i jakości; Prometheus z Grafaną do metryk operacyjnych.
Platformy zarządzane: AWS SageMaker, Google Vertex AI, Azure Machine Learning, Databricks, a każda z nich łączy kilka wymienionych wyżej elementów.
Dla aplikacji opartych na modelach językowych: LangSmith, Langfuse i Braintrust, które wspierają wersjonowanie promptów i ocenę wyników; ten obszar bywa czasem określany jako LLMOps.
Jakie są kluczowe cechy MLOps?
Dane są wersjonowane razem z kodem. Odtworzenie modelu wymaga dokładnie tych samych danych treningowych, dlatego zbiory danych traktuje się jak wersjonowane artefakty.
Ponowne trenowanie jest zautomatyzowane i rutynowe. Ponieważ modele z czasem tracą jakość, ponowne trenowanie odbywa się w zaplanowanym pipeline'ie z bramkami walidacyjnymi.
Monitoring obejmuje jakość i dostępność. Model może być stale dostępny, a jednocześnie konsekwentnie się mylić. To wykrywanie driftu i śledzenie trafności odróżnia monitoring MLOps od standardowego monitoringu aplikacji.
Wdrożenie jest stopniowe i odwracalne. Nowe modele najpierw obsługują tylko część ruchu, a szybki rollback jest zawsze dostępny, ponieważ metryki offline nie przewidują w pełni zachowania modelu na produkcji.
Obliczanie cech jest współdzielone między trenowaniem a serwowaniem modelu. Te same ścieżki kodu generują cechy w obu tych kontekstach, co eliminuje jedną z klas cichej utraty trafności.
Pochodzenie można prześledzić end-to-end. Dla każdej predykcji możesz wskazać wersję modelu oraz dokładne dane i kod, które za nią stoją. To niezbędne przy debugowaniu i wymagane w środowiskach regulowanych.
Jakie korzyści daje MLOps?
Modele trafiają na produkcję. Zautomatyzowane, powtarzalne ścieżki wdrożeniowe usuwają ręczne wąskie gardło, przez które wytrenowane modele gromadzą się w notebookach i nigdy nie są wdrażane.
Spadek jakości jest wykrywany, zanim zacznie kosztować. Monitoring driftu i trafności ujawnia problemy, gdy są jeszcze niewielkie, zanim uzbiera się cały kwartał słabych decyzji.
Szybsze iteracje nad jakością modeli. Gdy ponowne trenowanie i wdrożenie są zautomatyzowane, poprawa modelu zajmuje dni. Zespoły robiące to ręcznie iterują wielokrotnie wolniej.
Odtwarzalność i możliwość audytu. Wersjonowanie danych razem z kodem i modelami oznacza, że każdy wcześniejszy wynik można odtworzyć, a każdą wcześniejszą decyzję wyjaśnić. To wymóg regulacyjny w finansach i ochronie zdrowia, a coraz częściej także w kontekście unijnego AI Act.
Mniejsza zależność od konkretnych osób. Udokumentowane pipeline'y i rejestry sprawiają, że wiedza o modelu jest zapisana w systemie, niezależnie od data scientista, który go stworzył.
Niższy koszt serwowania. Systematyczny monitoring opóźnień i zużycia zasobów pokazuje, gdzie mniejszy model albo lepsze batchowanie zapewni wystarczającą jakość przy niższym koszcie.
Jakie wyzwania i kompromisy wiążą się z MLOps?
Narzędzia są rozproszone i szybko się zmieniają. Żadne pojedyncze narzędzie nie obejmuje dobrze całego cyklu życia, więc zespoły łączą kilka rozwiązań i utrzymują integrację między nimi. Decyzje podjęte dwa lata temu często przestają być dziś rozsądnym wyborem domyślnym.
Nakład pracy infrastrukturalnej może przewyższyć pracę nad modelem. Zbudowanie pipeline'ów i monitoringu wokół nich to duży wysiłek inżynierski, a przy jednym modelu o niewielkim znaczeniu biznesowym może się to po prostu nie opłacać.
Ground truth często pojawia się z opóźnieniem albo wcale. Pomiar trafności wymaga znajomości rzeczywistego wyniku. W przypadku modelu churn może to zająć miesiące, a dla części decyzji scenariusz kontrfaktyczny nigdy nie jest obserwowalny, więc trzeba opierać się na metrykach zastępczych i wykrywaniu driftu.
Wymaga kompetencji zarówno z data science, jak i platform engineeringu. Rzadko jedna osoba łączy oba te obszary, dlatego skuteczny MLOps zwykle wymaga współpracy między rolami, które często raportują do różnych części organizacji.
Nadmierne rozbudowanie rozwiązania to ryzyko dla małych zespołów. Pełna platforma to zbyt dużo jak na jeden model obsługujący decyzję o niewielkich konsekwencjach. Najlepiej zacząć od kontroli wersji i skryptu wdrożeniowego, a potem dodać monitoring.
Ponowne trenowanie może pogorszyć model. Zautomatyzowane ponowne trenowanie na najnowszych danych przejmie także wszystkie problemy obecne w tych danych, w tym pętle sprzężenia zwrotnego wywołane wcześniejszymi predykcjami samego modelu. W przypadku modeli o istotnych konsekwencjach konieczne są bramki walidacyjne i akceptacja człowieka.
Czy wybrać MLOps czy standardowy DevOps?
Czynnik | MLOps | DevOps |
Wersjonowane artefakty | Kod, dane i wagi modelu | Kod |
Podejście do testowania | Ocena statystyczna na wydzielonych danych testowych | Deterministyczny wynik: zaliczone albo niezaliczone |
Tryb awarii | Cichy spadek trafności | Błędy, awarie, przestoje |
Priorytet monitoringu | Drift i jakość predykcji oraz dostępność | Dostępność, opóźnienia, wskaźnik błędów |
Powód ponownego wdrożenia | Dane się zmieniły; model uległ driftowi | Zmienił się kod |
Co uruchamia rollback | Pogorszenie jakości predykcji | Nieudane wdrożenie albo nagły wzrost liczby błędów |
FAQ o MLOps
Powiązane pojęcia
MLOps: potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
POZNAJ USŁUGI AIPOZNAJ USŁUGI AI