Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Mitygacja ryzyka
Zestaw działań, które zespół podejmuje, by zmniejszyć prawdopodobieństwo wystąpienia zidentyfikowanego ryzyka albo ograniczyć szkody, jakie spowodowałoby, gdyby się zmaterializowało.
Czym jest mitygacja ryzyka?
Rejestr ryzyk pokazuje zespołowi, co może pójść nie tak. Mitygacja polega na tym, że zespół decyduje, ile pracy warto wykonać już teraz, aby zmniejszyć prawdopodobieństwo wystąpienia ryzyka albo obniżyć koszt poradzenia sobie z nim, jeśli jednak się zmaterializuje.
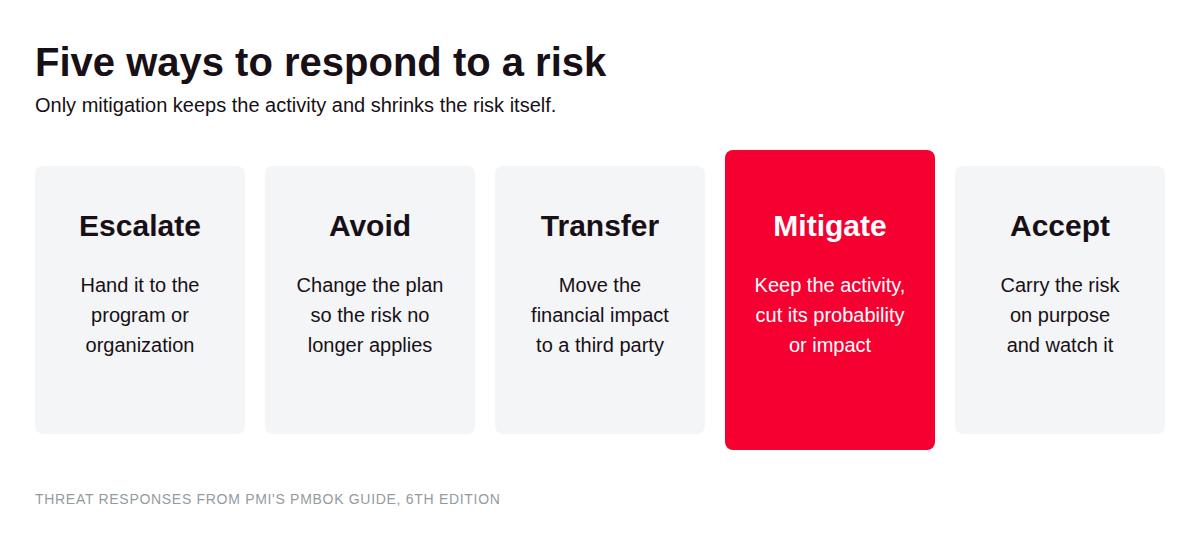
W standardach zarządzania projektami mitygacja to jedna z konkretnych reakcji, a nie ogólne określenie na radzenie sobie z ryzykiem. PMBOK Guide PMI (wydanie 6.) wymienia pięć reakcji na zagrożenia: eskalację, unikanie, przeniesienie, mitygację i akceptację. Mitygacja to reakcja, w której zespół pozostawia ryzykowne działanie w planie i pracuje nad jego prawdopodobieństwem albo skutkami. ISO 31000:2018 posługuje się szerszym językiem i wymienia siedem opcji postępowania z ryzykiem, z czego dwie polegają na zmianie prawdopodobieństwa oraz zmianie konsekwencji.
W dostarczaniu oprogramowania mitygacja zwykle wygląda dość zwyczajnie: proof-of-concept przed podjęciem zobowiązania do nieznanej integracji, etapowe wdrożenie za feature flagem, drugi inżynier, który poznaje moduł rozliczeń, kopia zapasowa przetestowana przez rzeczywiste odtworzenie. Żadne z tych działań nie usuwa ryzyka. Każde zmniejsza je do poziomu, który zespół jest gotów zaakceptować.
Dlaczego mitygacja ryzyka ma znaczenie w projektach informatycznych?
Mitygacja ryzyka jest ważna, bo samo zidentyfikowanie ryzyka niczego w nim nie zmienia. Tylko zaplanowana reakcja zmienia prawdopodobieństwo albo skalę szkód.
Zamienia rejestr ryzyk w plan dostarczania. Większość zespołów potrafi wypisać ryzyka podczas warsztatów kickoffowych. Dopóki do każdego ryzyka nie jest przypisane konkretne działanie, taka lista pozostaje tylko zapisem obaw i nikt do niej nie wraca, dopóki jedno z tych ryzyk już się nie zmaterializuje.
Przekuwa zobowiązania wobec klienta w konkretne działania. Terminy i budżety w kontrakcie o stałym zakresie zakładają, że znane ryzyka zostały uwzględnione w wycenie. Mitygacja sprawia, że to założenie ma pokrycie w realnej pracy, więc opóźniona integracja albo nieudana migracja kosztuje dni, a nie całe wydanie.
Przenosi koszt do najtańszego momentu. Zajęcie się ryzykiem na etapie discovery zwykle kosztuje jedną rozmowę albo krótki proof-of-concept. To samo ryzyko wykryte na produkcji oznacza już obsługę incydentu i utratę zaufania klienta.
Jak działa mitygacja ryzyka?
Mitygacja ryzyka działa w pętli: wybierasz ryzyka, którymi warto się zająć, dobierasz działania obniżające prawdopodobieństwo albo skutki, przypisujesz je do odpowiedzialnych osób, a potem mierzysz, co jeszcze pozostało.
Ustal priorytety na podstawie oceny. Mitygacja zaczyna się od oceny ryzyka, w której każde ryzyko otrzymuje ocenę prawdopodobieństwa i wpływu. Prace mitygujące obejmują tylko te ryzyka, które przekraczają poziom tolerancji zespołu. Pozostałe są akceptowane i monitorowane.
Wybierz właściwą dźwignię. Działania zapobiegawcze wpływają na prawdopodobieństwo, na przykład code review dla wrażliwego modułu albo testy obciążeniowe przed uruchomieniem. Działania awaryjne ograniczają skutki, na przykład plan rollbacku albo przetestowane odtworzenie z kopii zapasowej. Wiele ryzyk wymaga obu typów działań.
Porównaj koszt działania z ekspozycją, którą usuwa. Pomaga w tym proste sprawdzenie wartości oczekiwanej. Jeśli integracja ma 30% szans na opóźnienie o 10 dni roboczych, oczekiwane opóźnienie wynosi 3 dni. Gdy 2-dniowy proof-of-concept obniża to prawdopodobieństwo do 5%, oczekiwane opóźnienie spada do 0,5 dnia, więc 2 dni pracy usuwają 2,5 dnia oczekiwanego opóźnienia. To umiarkowana korzyść, a ta sama arytmetyka pokazuje też, kiedy mitygacja nie jest warta wykonania.
Przypisz właściciela i wyzwalacz. Każde działanie ma wskazaną odpowiedzialną osobę i termin. Działania awaryjne mają też wyzwalacz: sygnał, taki jak próg błędów albo niedotrzymany kamień milowy, który mówi zespołowi, kiedy uruchomić plan awaryjny.
Oceń ponownie i zamknij temat. Gdy działanie zostanie wykonane, zespół ponownie ocenia ryzyko. Jeśli to, co pozostało, nadal przekracza poziom tolerancji, potrzebna jest kolejna runda prac. Jeśli ryzyko przestaje w ogóle mieć zastosowanie, związane z nim działania mitygujące zostają zamknięte, aby rejestr odzwierciedlał aktualny stan projektu.
Jakich narzędzi zespoły używają do mitygacji ryzyka?
Większość zespołów łączy narzędzie do śledzenia ryzyk i planów postępowania z ryzykiem z narzędziami delivery, które same realizują mitygację, głównie kontrolą wydań i monitoringiem.
Rejestry ryzyk i platformy GRC
Vanta, LogicGate Risk Cloud i ServiceNow Integrated Risk Management łączą każde zarejestrowane ryzyko z planem postępowania i śledzą, czy zaplanowane działania zostały wykonane. Sprawdzają się w zespołach, które potrzebują też rejestru jako dowodu zgodności z przepisami. Mniejsze zespoły produktowe często przechowują te same informacje w osobnym projekcie Jira albo we współdzielonym arkuszu kalkulacyjnym.
Feature flagi i progressive delivery
LaunchDarkly, Unleash i Flagsmith pozwalają zespołom najpierw udostępnić ryzykowną zmianę małej części użytkowników, a potem wyłączyć ją bez ponownego wdrożenia. Dzięki temu skutki nieudanego wydania ograniczają się do użytkowników, którzy je zobaczyli, i do minut potrzebnych na przełączenie flagi.
Monitoring i reagowanie na incydenty
Sentry, Datadog i PagerDuty wspierają mitygację awaryjną, która działa tylko wtedy, gdy zespół szybko dowiaduje się, że ryzyko się zmaterializowało. Sentry śledzi błędy aplikacji, a Datadog obejmuje metryki infrastruktury i wydajności. PagerDuty kieruje powstałe alerty do osoby pełniącej dyżur i eskaluje je, jeśli nikt nie reaguje.
Jakie są kluczowe cechy mitygacji ryzyka?
Skuteczna mitygacja ryzyka jest powiązana z konkretnym ryzykiem i ma skalę dopasowaną do kosztu, jaki to ryzyko może spowodować.
Ma datę graniczną. Mitygacja pomaga tylko wtedy, gdy zostanie wdrożona, zanim ryzyko będzie mogło się zmaterializować. Test obciążeniowy zaplanowany na tydzień po uruchomieniu może nadal być przydatny, ale nie wpłynie już na nic, od czego to uruchomienie zależało.
Pozostawia ryzyko rezydualne. Mitygacja zmniejsza ryzyko, ale go nie usuwa. Całkowite usunięcie ryzyka to unikanie, czyli inna reakcja i inna cena. To, co zostaje po mitygacji, to ryzyko rezydualne, a zespół musi zdecydować, czy ten pozostały poziom jest akceptowalny.
Skaluje się wraz z ekspozycją. Ryzyko, które może opóźnić uruchomienie o kwartał, uzasadnia tygodnie pracy mitygującej. Ryzyko, które może kosztować jedno popołudnie, uzasadnia jedynie notatkę w rejestrze.
Zmienia się wraz z fazą projektu. Na początku mitygacja dotyczy niepewności, przez proof-of-concepty i prototypy. Później dotyczy operacji, przez plany rollbacku i monitoring dyżurowy.
Jakie korzyści daje mitygacja ryzyka?
Najważniejsza korzyść z mitygacji ryzyka jest taka, że problemy, które zespół przewidział, okazują się mniejsze albo nie pojawiają się wcale.
Szybsza reakcja, gdy ryzyko się zmaterializuje. Plan awaryjny uzgodniony podczas planowania zamienia incydent w checklistę. Zespół spędza pierwszą godzinę na realizacji decyzji, którą już wcześniej podjął, zamiast dyskutować o opcjach z klientem podczas rozmowy.
Szacunki, których łatwiej bronić. W szacunkach można wskazać, które ryzyka zostały objęte mitygacją, a które pozostają po stronie projektu, więc każdy bufor w harmonogramie ma jasno określone uzasadnienie.
Mniejsze incydenty. Działania awaryjne, takie jak plany rollbacku i feature flagi, ograniczają liczbę użytkowników dotkniętych awarią i czas jej trwania.
Gotowe dowody zgodności z przepisami. ISO/IEC 27001 wymaga udokumentowanego planu postępowania z ryzykiem, a Trust Services Criteria w SOC 2 obejmują kategorię mitygacji ryzyka. Prowadzony na bieżąco rejestr z zapisami działań mitygujących pokrywa dużą część tego, o co pytają audytorzy.
Świadoma akceptacja. Gdy mitygacja ma określoną cenę, zespoły mogą celowo zaakceptować część ryzyk i zapisać dlaczego, zamiast brać je na siebie domyślnie.
Jakie wyzwania wiążą się z mitygacją ryzyka?
Najtrudniejsze w mitygacji ryzyka jest płacenie za nią, zanim ktokolwiek zobaczy, czemu udało się zapobiec.
Skuteczna mitygacja wygląda jak zmarnowane pieniądze. Jeśli ryzyko nigdy się nie zmaterializuje, nikt nie udowodni, że ten wydatek miał znaczenie. Zapisywanie rozumowania opartego na wartości oczekiwanej w momencie podejmowania decyzji pomaga, ale zwiększa nakład pracy przy każdej mitygacji i nadal nie przekona kogoś, kto ocenia decyzje wyłącznie po rezultatach.
Mitygacja konkuruje z pracą nad funkcjami. Zadania mitygujące korzystają z tego samego backlogu i tych samych inżynierów co widoczne funkcje. Zarezerwowanie stałej części każdego sprintu daje im ochronę, ale ten potencjał jest bezpośrednio zabierany z zakresu, który klient widzi.
Szacunki prawdopodobieństwa to zgadywanie. Sprawdzenie wartości oczekiwanej jest tylko tak dobre, jak wpisane do niego 30%. Zespoły mogą kalibrować takie szacunki na podstawie danych z poprzednich projektów, ale to wymaga zapisów, których większość zespołów nie prowadzi, a przy nowatorskiej pracy nie ma żadnej historii, do której można się odnieść.
Mitygacja wnosi własne ryzyka. Zapasowy dostawca wymaga własnej integracji, a warstwa cache dodana, by ograniczyć ryzyko opóźnień, wprowadza ryzyko nieaktualnych danych. Rejestrowanie tych wtórnych ryzyk pozwala zachować uczciwość rejestru, ale jednocześnie go wydłuża i spowalnia przegląd.
Czym mitygacja ryzyka różni się od innych reakcji na ryzyko?
Mitygacja to reakcja na zagrożenie, w której ryzykowne działanie pozostaje w planie, a samo ryzyko zostaje ograniczone. Unikanie zmienia plan tak, by ryzyko przestało mieć zastosowanie, podczas gdy przeniesienie i akceptacja pozostawiają jego prawdopodobieństwo dokładnie na tym samym poziomie.
Aspekt | Mitygacja | Unikanie | Przeniesienie | Akceptacja |
Wpływ na prawdopodobieństwo | Zmniejszane przez działania zapobiegawcze | Usunięte dla tego ryzyka | Bez zmian | Bez zmian |
Wpływ na skutki | Zmniejszane przez działania awaryjne | Usunięte dla tego ryzyka | Finansowa część skutków przechodzi na stronę trzecią, ale wpływ operacyjny często pozostaje | Bez zmian, czasem kompensowane przez rezerwę awaryjną |
Koszt początkowy | Czas pracy inżynierów albo narzędzia | Utrata części zakresu albo zmiana planu | Opłaty kontraktowe albo składki ubezpieczeniowe | Brak, poza ewentualną rezerwą awaryjną |
Przykład z tworzenia oprogramowania | Wdrażanie migracji płatności za feature flagem | Usunięcie niezweryfikowanej integracji z zakresu MVP | Zakup cyberubezpieczenia pokrywającego koszty reakcji na naruszenie | Tolerowanie rzadkiego błędu wyświetlania w wewnętrznym narzędziu administracyjnym |
Ma sens, gdy | Warto utrzymać dane działanie, a koszt reakcji jest niższy niż ekspozycja, którą usuwa | Dane działanie nie jest warte związanej z nim ekspozycji | Strona trzecia może taniej przejąć konsekwencje finansowe | Każda dostępna reakcja kosztuje więcej niż oczekiwana strata |
Piąta reakcja na zagrożenie w PMBOK, czyli eskalacja, ma zastosowanie wtedy, gdy ryzyko wykracza poza kompetencje projektu i zostaje przekazane komuś na poziomie programu albo całej organizacji.
FAQ o mitygacji ryzyka
Powiązane pojęcia
Mitygacja ryzyka: potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
EXPLORE WEB DEVELOPMENT SERVICESEXPLORE WEB DEVELOPMENT SERVICES