Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Architektura serverless
Architektura serverless to model chmurowy, w którym kod aplikacji działa jako krótkotrwałe funkcje i usługi zarządzane, a dostawca odpowiada za serwery i skaluje je na żądanie.
Czym jest architektura serverless?
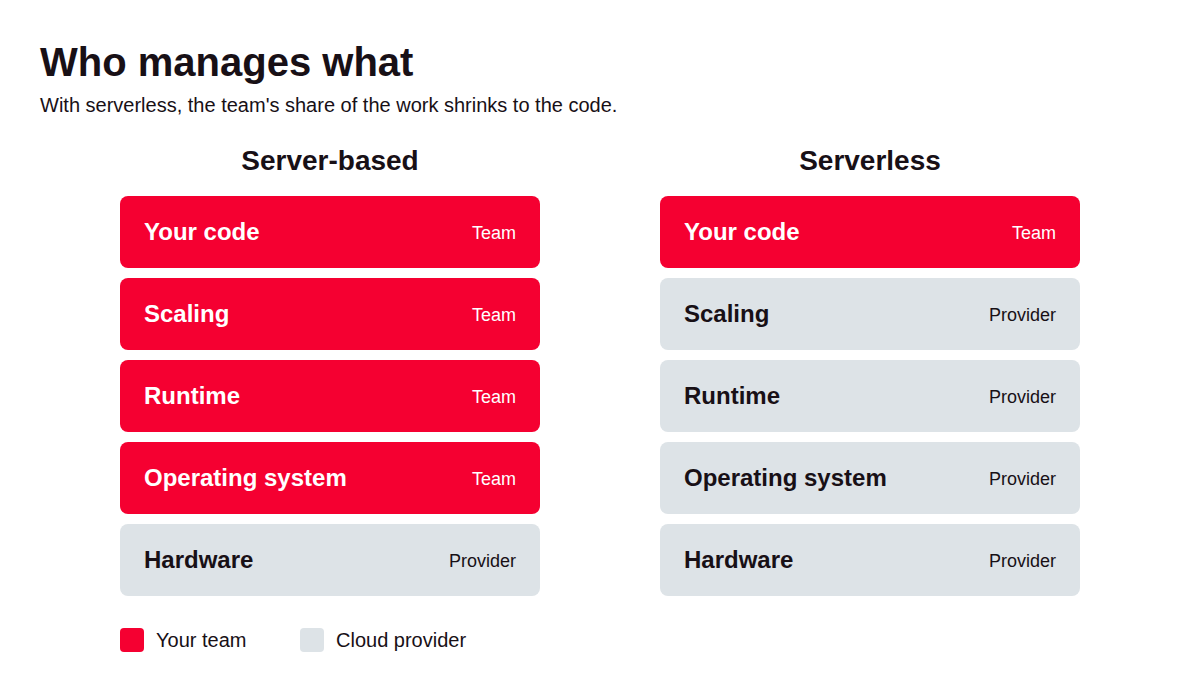
Architektura serverless ma jeden główny cel: przestać płacić za niewykorzystywane zasoby i przestać je utrzymywać. Zespół tworzy logikę biznesową, a dostawca chmury decyduje, kiedy kod się uruchamia i ile jego instancji działa w danym momencie.
Za kulisami te maszyny należą do AWS, Microsoftu, Google lub Cloudflare, a ich aktualizowanie i dobieranie do obciążenia leży po stronie dostawcy. Jednostką pracy przestaje być „serwer, na którym działa nasza aplikacja”, a staje się nią „funkcja uruchamiana, gdy coś się wydarzy”.
Ta zmiana obejmuje dwa rodzaje elementów składowych. Functions as a service (FaaS), takie jak AWS Lambda, uruchamiają własny kod w odpowiedzi na zdarzenia. Zarządzane usługi backendowe, takie jak hostowane bazy danych i kolejki komunikatów, przechowują stan i obsługują zaplecze, od którego zależą funkcje. System serverless zwykle łączy oba te elementy i spina je zdarzeniami.
Dlaczego architektura serverless ma znaczenie dla zespołów produktowych?
Serverless zmienia zarówno to, za co płaci zespół, jak i to, jakie zasoby musi zabezpieczyć, dlatego jest to w równym stopniu decyzja biznesowa, co techniczna.
Koszty infrastruktury zależą od rzeczywistego użycia, a nie od prognoz. Przy serwerach działających bez przerwy zespół płaci za przewidywany szczyt obciążenia, niezależnie od tego, czy ruch faktycznie się pojawi. W modelu serverless wewnętrzne narzędzie używane dwa razy dziennie kosztuje praktycznie nic.
Małe zespoły mogą pominąć cały poziom prac operacyjnych. Aktualizacje systemu operacyjnego i awarie hostów stają się odpowiedzialnością dostawcy. Dla startupu albo zespołu produktowego bez dedykowanych inżynierów DevOps oznacza to więcej czasu na dostarczanie funkcji.
Jak działa architektura serverless?
Żądanie w architekturze serverless za każdym razem przechodzi przez ten sam cykl: pojawia się zdarzenie, a platforma uruchamia kod w środowisku, które albo wykorzystuje ponownie, albo tworzy na miejscu.
Zdarzenie uruchamia funkcję. Programiści nie piszą serwera, który czeka na ruch. Funkcja uruchamia się w odpowiedzi na wywołanie HTTP przez bramę API, zapis pliku w pamięci obiektowej, komunikat w kolejce albo zaplanowany timer.
Platforma przygotowuje środowisko wykonawcze. Jeśli dostępne jest ciepłe środowisko z niedawnego żądania, platforma używa go ponownie. Jeśli nie, uruchamia nowe, wczytując runtime i kod funkcji. To opóźnienie nazywa się cold startem.
Współbieżność skaluje się wraz z popytem. W AWS Lambda każde równoczesne żądanie dostaje własne środowisko, więc nagły wzrost do 500 żądań może oznaczać 500 środowisk. Funkcje Google Cloud Run mogą natomiast kierować kilka żądań do jednej instancji. AWS Lambda domyślnie ustawia limit 1 000 współbieżnych wykonań na region, który można podnieść na wniosek.
Każda funkcja działa z własnym zestawem uprawnień. Platforma przypisuje każdej funkcji tożsamość, w AWS Lambda jest to rola wykonawcza IAM, która kontroluje, do których baz danych albo bucketów pamięci może się ona dostać. Ograniczenie tych uprawnień zmniejsza skalę szkód, jeśli jedna z funkcji zostanie naruszona.
Rozliczenie obejmuje liczbę żądań i czas wykonania. AWS Lambda nalicza opłaty za każde żądanie oraz czas trwania wykonania, zaokrąglony w górę do najbliższej milisekundy i ważony według przydzielonej pamięci.
Jakich narzędzi zespoły używają w architekturze serverless?
Narzędzia serverless dzielą się na platformy uruchamiające funkcje oraz frameworki do ich definiowania i wdrażania, a osobną wyspecjalizowaną gałąź tych platform stanowią środowiska edge.
Platformy funkcji chmurowych: AWS Lambda, Azure Functions i funkcje Google Cloud Run (dawniej Cloud Functions). Uruchamiają kod w regionalnych centrach danych dostawcy i integrują się z jego bazami danych oraz usługami tożsamości.
Środowiska uruchomieniowe funkcji edge: Cloudflare Workers, Fastly Compute i Deno Deploy. Uruchamiają lekki kod w lokalizacjach blisko użytkowników, co zmniejsza opóźnienia w zadaniach takich jak kierowanie żądań czy sprawdzanie uwierzytelnienia.
Frameworki infrastructure-as-code: AWS SAM, Serverless Framework i SST. Opisują funkcje oraz ich wyzwalacze w plikach konfiguracyjnych, dzięki czemu system serverless można wersjonować i wdrażać ponownie jak każdy inny kod.
Jakie są kluczowe cechy architektury serverless?
Aplikacje tworzone w modelu serverless mają wspólne cechy projektowe, które wpływają zarówno na sposób pisania kodu, jak i na to, gdzie jest on uruchamiany.
Architektura sterowana zdarzeniami. Logika jest zorganizowana wokół tego, co się dzieje, na przykład złożenia zamówienia albo przesłania pliku. Komponenty komunikują się przez emitowanie zdarzeń i reagowanie na nie, zamiast wywoływać się bezpośrednio.
Drobne jednostki wdrożeniowe. Każdą funkcję można wdrożyć osobno. Poprawka błędu w generatorze faktur trafia na produkcję bez ingerencji w proces logowania.
Bezstanowe przetwarzanie. Funkcja nie może zakładać, że pamięć lub lokalny dysk przetrwają do kolejnego wywołania. Programiści piszą każde wywołanie tak, jakby było pierwsze, a stan odczytują i zapisują przez usługi zewnętrzne.
Limity narzucane przez dostawcę. Platforma ogranicza to, co może zrobić pojedyncze wywołanie. W standardowych funkcjach AWS Lambda jedno wywołanie trwa maksymalnie 15 minut, a przydział pamięci może wynosić od 128 MB do 10 240 MB.
Silne oparcie na usługach zarządzanych. Backend serverless składa się z elementów dostawcy, takich jak uwierzytelnianie i pamięć masowa. Zespół pisze mniej kodu infrastrukturalnego, a więcej kodu spinającego usługi.
Jakie są korzyści architektury serverless?
Największe korzyści widać przy obciążeniach o nierównym ruchu i w zespołach, które chcą poświęcać czas na kod produktu.
Brak kosztów przestoju. Obciążenia działające skokowo, takie jak nocne raporty czy obsługa webhooków, przestają generować koszty w godzinach pomiędzy uruchomieniami. AWS uwzględnia też w bezpłatnym planie Lambda milion żądań i 400 000 GB-sekund miesięcznie.
Skalowanie bez planowania zasobów. Skoki ruchu obsługuje platforma, dodając kolejne środowiska aż do limitu współbieżności na koncie. Nikt nie musi przewidywać przyszłomiesięcznego szczytu i przygotowywać pod niego zasobów.
Szybsza droga do pierwszego wydania. Skoro nie trzeba konfigurować serwerów, zespół może uruchomić endpoint API nawet w ciągu jednego dnia. To dobre podejście do MVP i eksperymentów, w których produkt może jeszcze zmienić kształt, zanim inwestycja w infrastrukturę zacznie się opłacać.
Mniejszy obszar awarii przy każdej zmianie. Ponieważ funkcje wdraża się niezależnie, wadliwe wydanie zwykle psuje jedną funkcję zamiast całej aplikacji. Wycofanie zmiany sprowadza się do ponownego wdrożenia jednej funkcji.
Jakie są wyzwania architektury serverless?
Większość problemów serverless ma znane rozwiązania, a każde z nich odbiera część tego, co na początku czyniło ten model atrakcyjnym.
Cold starty zwiększają opóźnienia. Pierwsze żądanie do nowego środowiska czeka na załadowanie runtime'u, co użytkownicy zauważają przy interaktywnych endpointach. Provisioned concurrency utrzymuje środowiska w gotowości, ale AWS nalicza za nią opłaty przez cały skonfigurowany okres, także w godzinach bez ruchu, co przywraca koszt bezczynności, który serverless miał wyeliminować.
Lock-in sięga głębiej niż sam kod. Logikę funkcji da się przenieść, ale ich wyzwalacze i integracje z usługami są specyficzne dla jednego dostawcy. Frameworki abstrakcji obniżają koszt zmiany, ale ceną jest dodatkowa warstwa i dostęp tylko do funkcji wspieranych przez wszystkich dostawców.
Stały, wysoki ruch może kosztować więcej. Model pay-per-use staje się droższy od zawsze dostępnych zasobów, gdy obciążenie działa przez całą dobę blisko pełnego wykorzystania. Przeniesienie tych najbardziej obciążonych ścieżek do kontenerów obniża rachunek, ale zostawia zespół z dwoma modelami wdrożeń działającymi równolegle.
Debugowanie obejmuje wiele ruchomych elementów. Jedno działanie użytkownika może przejść przez bramę API, kilka funkcji, kolejkę i bazę danych, a żaden pojedynczy log nie pokazuje całej ścieżki. Narzędzia do distributed tracingu, takie jak AWS X-Ray, przywracają ten widok, ale każdą funkcję trzeba zinstrumentować, a samo śledzenie też jest płatne.
Długie zadania wymagają przeprojektowania. Prace, które przekraczają limit czasu platformy, trzeba podzielić na kroki koordynowane przez usługę workflow, taką jak AWS Step Functions. To działa, ale dochodzi kod orkiestracji i opłaty za workflow, których nie byłoby przy jednym długotrwałym procesie.
Jaka jest różnica między architekturą serverless a architekturą opartą na serwerach?
Serverless zamienia kontrolę nad środowiskiem uruchomieniowym na brak konieczności jego utrzymywania, podczas gdy architektura oparta na serwerach, czy to na maszynach wirtualnych, czy na samodzielnie zarządzanych klastrach kontenerów, pozostawia tę kontrolę i związane z nią utrzymanie po stronie zespołu.
Funkcje serverless | Samodzielnie zarządzane serwery lub kontenery | |
|---|---|---|
Jednostka wdrożenia | Pojedyncza funkcja | Cała aplikacja lub obraz usługi |
Rozliczenie | Za żądanie i czas wykonania | Za przydzielone zasoby, niezależnie od tego, czy są wykorzystywane, czy pozostają bezczynne |
Skalowanie | Platforma dodaje środowiska do obsługi kolejnych żądań, aż do zera | Skalowaniem zarządza zespół, ręcznie albo przez reguły autoskalowania, przy zachowaniu minimalnej liczby uruchomionych instancji |
Czas wykonania | Ograniczony przez dostawcę | Brak limitu czasu procesu narzuconego przez platformę |
Stan między żądaniami | Nie jest gwarantowany, przechowywany w usługach zewnętrznych | Może być przechowywany w pamięci procesu |
Aktualizacje systemu operacyjnego i runtime'u | Po stronie dostawcy | Po stronie zespołu |
FAQ o architekturze serverless
Powiązane pojęcia
Architektura serverless: potrzebujesz wsparcia ekspertów?
Monterail tworzy oprogramowanie na zamówienie z wykorzystaniem najnowszych technologii. Porozmawiajmy o tym, jak możemy pomóc w Twoim projekcie.
EXPLORE WEB DEVELOPMENT SERVICESEXPLORE WEB DEVELOPMENT SERVICES