Nowy standard. Twoje centrum tworzenia inteligentnego, szybkiego i zrównoważonego oprogramowania AI
Table of Contents
Prototypowanie backendu wiąże się z pewnym tarciem. Masz pomysł, chcesz go szybko sprawdzić, ale zanim wykonasz choć jedno wywołanie API, spędzasz godziny na boilerplate: definiowaniu tras, konfigurowaniu uwierzytelniania, podłączaniu bazy danych i obsłudze odpowiedzi na błędy.
Ta praca przygotowawcza jest konieczna, ale mało interesująca — nie weryfikuje twojego pomysłu, tylko poprzedza tę weryfikację.
LLM-y to zmieniają.
Łącząc dobrze uporządkowaną specyfikację OpenAPI v3 z wydajnym modelem językowym oraz asystentem AI do pisania kodu, takim jak aider, możesz przejść od pomysłu opisanego prostym językiem do działającego prototypu backendu w ułamku czasu, jakiego wymaga tradycyjna konfiguracja.
W tym artykule przechodzimy przez cały proces krok po kroku, opierając się na praktycznym przykładzie.
Podsumowanie dla decydentów
Wykorzystanie LLM-ów do generowania prototypów backendu na podstawie specyfikacji OpenAPI v3 to proces składający się z czterech kroków: opisujesz swój pomysł prostym językiem, pozwalasz LLM-owi wygenerować kompletną specyfikację OpenAPI v3, używasz tej specyfikacji do zbudowania szkieletu implementacji backendu, a następnie automatycznie generujesz klientów HTTP na podstawie tej samej specyfikacji.
Kluczowy wniosek jest taki, że specyfikacja OpenAPI pełni rolę uporządkowanej warstwy pośredniej — jest wystarczająco precyzyjna do generowania kodu, a jednocześnie powstaje z języka naturalnego zamiast być pisana ręcznie.
Efektem jest działający szkielet backendu gotowy w ciągu godzin, a nie dni, z bezpieczeństwem, obsługą błędów i spójnymi modelami danych uwzględnionymi od samego początku.
Dlaczego LLM-y zmieniają prototypowanie backendu
Firmy są stale pod presją, by szybko wprowadzać produkty na rynek, dostosowywać się do zmieniających się potrzeb użytkowników i bezproblemowo się skalować. Tradycyjne prototypowanie backendu, choć niezawodne, tworzy wąskie gardła — szczególnie przy ręcznej interpretacji i implementacji złożonych specyfikacji API.
LLM-y rozwiązują ten problem na cztery konkretne sposoby.
Po pierwsze, automatyzują powtarzalne zadania programistyczne które spowalniają wczesny etap tworzenia oprogramowania: konfigurowanie tras API, konfigurację baz danych i pisanie boilerplate.
Generując kod backendu bezpośrednio na podstawie uporządkowanych danych wejściowych, takich jak specyfikacje OpenAPI v3, pozwalają zespołom skupić się na logice biznesowej i architekturze zamiast na rutynowej konfiguracji.
Po drugie, poprawiają spójność. Ręczna interpretacja specyfikacji API prowadzi do błędów — źle skonfigurowanych typów danych, pominiętych reguł walidacji i niespójnej obsługi błędów.
Jeśli dostanie dobrze zdefiniowany dokument OpenAPI v3, LLM wygeneruje spójny kod, ściśle zgodny z pierwotną specyfikacją, co od początku ogranicza ryzyko błędów.
Po trzecie, lepiej radzą sobie ze zmianą niż ręcznie pisany boilerplate. Gdy specyfikacja API się zmienia, możesz zaktualizować specyfikację i poprosić model o ponowne wygenerowanie lub zmodyfikowanie odpowiednich części, zamiast wyszukiwać każde miejsce, w którym ta zmiana powinna zostać odzwierciedlona.
Po czwarte, ułatwiają pracę ze złożonymi architekturami. LLM-y mogą szybko zbudować szkielety wielu mikrousług, zachowując spójność między komponentami i upraszczając integrację — dzięki temu prototypy mogą ewoluować w kierunku systemów gotowych do wdrożenia produkcyjnego przy mniejszej liczbie przeróbek niż w przypadku zaczynania od zera.
Czteroetapowy proces
Proces łączy cztery etapy: wprowadzenie pomysłu, wygenerowanie specyfikacji OpenAPI, implementację backendu i wygenerowanie klientów HTTP.
Każdy etap jest odrębny, co ma znaczenie — oddzielenie generowania specyfikacji od generowania backendu daje LLM-owi bardziej precyzyjny kontekst na każdym kroku i ułatwia wprowadzanie poprawek.
Aby pokazać to na konkretnym przykładzie, w kolejnych krokach posłużymy się jednym scenariuszem: rozwiązaniem do przechowywania linków, które pozwala użytkownikom dodawać linki do stron, opatrywać je notatkami i oznaczać jako przeczytane.
Krok 1: wprowadzenie pomysłu i inicjalizacja
Proces zaczyna się od opisu tego, co chcesz zbudować, prostym językiem. To podstawa, która pomaga LLM-owi zrozumieć cele i wymagania aplikacji, zanim zapadną jakiekolwiek decyzje techniczne.
Aby uzyskać najlepsze rezultaty, początkowy prompt użytkownika powinien być zwięzły, konkretny i możliwie jak najbardziej precyzyjnie opisywać, co aplikacja ma robić.
Im precyzyjniej opiszesz kluczową funkcjonalność, tym trafniej LLM przełoży ją na język specyfikacji.
Krok 2: generowanie specyfikacji OpenAPI v3
Gdy pomysł jest już określony, LLM generuje specyfikację OpenAPI v3 opisującą operacje CRUD potrzebne do obsługi struktur danych aplikacji. Specyfikacja zawiera definicje zabezpieczeń z zakresem uprawnień, dzięki czemu każdy endpoint jest chroniony i dostępny wyłącznie dla uprawnionych użytkowników.
Prompt systemowy dla tego kroku:
Jesteś architektem oprogramowania. W kolejnych wiadomościach użytkownik przedstawi swój pomysł na aplikację. Twoim zadaniem jest przygotowanie specyfikacji OpenAPI v3 (YAML), która spełni wymagania podane w prompcie użytkownika oraz w tagu <general_requirements>.
<general_requirements>
- Upewnij się, że specyfikacja zawiera odpowiedzi na błędy, zwłaszcza dla przypadku nieprawidłowego żądania
- Upewnij się, że w specyfikacji znajdują się adnotacje dotyczące bezpieczeństwa. Każdy zdefiniowany endpoint powinien mieć dostęp oparty na zakresach określonych w tokenie JWT. Na przykład tworzenie powinno być możliwe wyłącznie dla użytkowników z odpowiednim zakresem w JWT.
- W miarę możliwości zachowaj modele danych jako komponenty, aby ułatwić ich ponowne wykorzystanie </general_requirements>
Warto wyjaśnić kilka decyzji dotyczących konstrukcji promptu:
Wskazano YAML zamiast JSON, ponieważ jest mniej restrykcyjny składniowo, dzięki czemu łatwiej modyfikować konkretne fragmenty bez ryzyka uszkodzenia formatu.
Odpowiedzi na błędy są wskazane wprost, ponieważ w specyfikacji OpenAPI są opcjonalne, ale kluczowe dla kodu gotowego do użycia w środowisku produkcyjnym — bez tego w prompcie LLM często je pomija.
Zabezpieczenia oparte na zakresach są wymagane wraz z konkretnym przykładem, ponieważ prosty prompt zwykle daje jedynie wymagania dotyczące tokena bearer bez szczegółowej kontroli dostępu. Schematy komponentów są wymagane wprost, aby specyfikacja pozostała czytelna i łatwa w utrzymaniu.
Poniższy wynik wygenerowano przy użyciu aider z użyciem modelu Codestral 25.01:
openapi: 3.0.0
info:
  title: API rozwiązania do przechowywania linków
  description: API dla rozwiązania do przechowywania linków, które pozwala użytkownikom dodawać,
    opisywać i oznaczać linki internetowe jako przeczytane.
  version: 1.0.0
servers:
  - url: https://api.link-keeping.com/v1
    description: Serwer produkcyjny
paths:
  /links:
    post:
      summary: Dodaj nowy link
      security:
        - bearerAuth: ["write:links"]
      requestBody:
        required: true
        content:
          application/json:
            schema:
              $ref: '#/components/schemas/LinkRequest'
      responses:
        '201':
          description: Link został pomyślnie utworzony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Link'
        '400':
          description: Nieprawidłowe żądanie
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '401':
          description: Brak autoryzacji
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '403':
          description: Dostęp zabroniony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
    get:
      summary: Pobierz wszystkie linki
      security:
        - bearerAuth: ["read:links"]
      responses:
        '200':
          description: Lista linków
          content:
            application/json:
              schema:
                type: array
                items:
                  $ref: '#/components/schemas/Link'
        '401':
          description: Brak autoryzacji
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '403':
          description: Dostęp zabroniony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
  /links/{id}:
    parameters:
      - name: id
        in: path
        required: true
        schema:
          type: string
        description: Identyfikator linku
    get:
      summary: Pobierz link po ID
      security:
        - bearerAuth: ["read:links"]
      responses:
        '200':
          description: Obiekt linku
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Link'
        '401':
          description: Brak autoryzacji
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '403':
          description: Dostęp zabroniony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '404':
          description: Nie znaleziono linku
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
    put:
      summary: Zaktualizuj link
      security:
        - bearerAuth: ["write:links"]
      requestBody:
        required: true
        content:
          application/json:
            schema:
              $ref: '#/components/schemas/LinkRequest'
      responses:
        '200':
          description: Link został pomyślnie zaktualizowany
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Link'
        '400':
          description: Nieprawidłowe żądanie
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '401':
          description: Brak autoryzacji
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '403':
          description: Dostęp zabroniony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '404':
          description: Nie znaleziono linku
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
    delete:
      summary: Usuń link
      security:
        - bearerAuth: ["delete:links"]
      responses:
        '204':
          description: Link został pomyślnie usunięty
        '401':
          description: Brak autoryzacji
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '403':
          description: Dostęp zabroniony
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
        '404':
          description: Nie znaleziono linku
          content:
            application/json:
              schema:
                $ref: '#/components/schemas/Error'
components:
  securitySchemes:
    bearerAuth:
      type: http
      scheme: bearer
      bearerFormat: JWT
  schemas:
    LinkRequest:
      type: object
      properties:
        url:
          type: string
          format: uri
          example: https://example.com
        title:
          type: string
          example: Przykładowa strona internetowa
        description:
          type: string
          example: To jest przykładowa strona internetowa.
      required:
        - url
    Link:
      type: object
      properties:
        id:
          type: string
          example: "12345"
        url:
          type: string
          format: uri
          example: https://example.com
        title:
          type: string
          example: Przykładowa strona internetowa
        description:
          type: string
          example: To jest przykładowa strona internetowa.
        read:
          type: boolean
          example: false
        annotations:
          type: array
          items:
            type: string
          example: []
    Error:
      type: object
      properties:
        message:
          type: string
          example: Wystąpił błąd
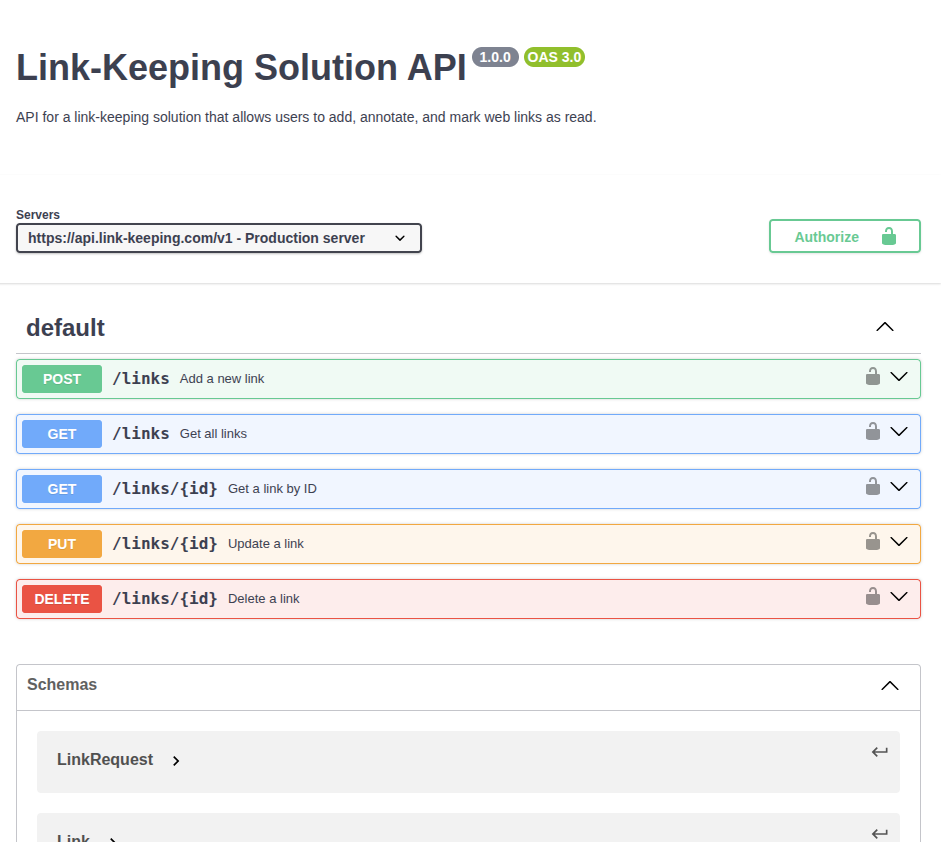
Powstałą specyfikację można zweryfikować w https://editor.swagger.io/.
Krok 3: Tworzenie prototypu backendu
Gdy specyfikacja OpenAPI jest zdefiniowana w osobnym pliku, generowanie backendu staje się odrębnym, skoncentrowanym procesem. Rozdzielenie tych kroków daje więcej przestrzeni w kontekście na poprawki i korekty wygenerowanego kodu backendu.
Ponieważ ten prototyp jest punktem wyjścia do rzeczywistego rozwoju oprogramowania, wybór technologii ma znaczenie — musisz móc później swobodnie pracować z wygenerowaną bazą kodu.
W tym przykładzie środowiskiem uruchomieniowym jest Node.js, a bazą danych SQLite.
LLM może wybrać framework HTTP, rozwiązanie do walidacji danych wejściowych, mechanizm weryfikacji uwierzytelniania, sterownik SQLite i inne zależności, choć możesz zawęzić te wybory jeszcze bardziej, jeśli masz własne preferencje.
Zakładając, że plik specyfikacji nazywa się openapi.yaml, prompt brzmi:
Na podstawie zawartości pliku openapi.yaml utwórz implementację backendu w Node.js,
używając SQLite do przechowywania i odczytywania danych użytkowników.
Aider automatycznie dodaje openapi.yaml do kontekstu i zamienia wynik LLM na poprawną strukturę plików na dysku. Wygenerowana struktura projektu:
├─ src/
│ ├─ controllers/
│ │ ├─ linkController.js
│ │ ├─ userController.js
│ │
│ ├─ routes/
│ │ ├─ linkRoutes.js
│ │ ├─ userRoutes.js
│ │
│ ├─ services/
│ │ ├─ authService.js
│ │
│ ├─ utils/
│ │ ├─ db.js
│ │
│ ├─ app.js
│
├─ .env
├─ package.json
LLM wygenerował sensowną strukturę projektu i, choć nikt go o to bezpośrednio nie prosił,utworzył endpointy rejestracji i logowania z logiką haszowania haseł – trafnie wnioskując, że aplikacja potrzebuje uwierzytelniania, żeby działać.
Zastosowano dobre praktyki programistyczne i bezpieczeństwa: sekret JWT można skonfigurować w pliku .env , definicje tras, kontrolerów i serwisów są poprawnie rozdzielone, a struktura bazy danych jest przygotowywana przed użyciem.
To pozwoliło zaoszczędzić wiele godzin pracy deweloperów, choć przed bezproblemowym uruchomieniem projektu potrzebne były jeszcze pewne ręczne poprawki.
Krok 4: generowanie klienta HTTP
Gdy masz już zweryfikowaną specyfikację OpenAPI, wygenerowanie klienta HTTP jest proste. Korzystając z istniejących generatorów na podstawie pliku specyfikacji z kroku 2, możesz wygenerować w 100% poprawne klienty HTTP bez żadnego dodatkowego udziału LLM.
To podejście jest bardziej niezawodne niż generowanie klientów z pomocą AI bezpośrednio na podstawie plików implementacyjnych, ponieważ specyfikacja jest czytelna maszynowo, a wynik generatora jest deterministyczny.
Zintegrowane rozwiązanie prototypowe
Efektem jest działający szkielet backendu, który spełnia początkowe wymagania aplikacji: zaimplementowane trasy, skonfigurowane uwierzytelnianie, spójne modele danych po stronie backendu i klienta oraz obsługa błędów obecna od początku.
Kluczowym elementem tego podejścia jest specyfikacja OpenAPI v3. Gdy najpierw generujesz specyfikację – w uporządkowanym formacie czytelnym maszynowo – zamiast generować kod bezpośrednio z opisu w języku naturalnym, cały proces staje się bardziej przewidywalny, a wynik bardziej niezawodny.
Specyfikacja pełni rolę kontraktu, z którego korzystają zarówno implementacja backendu, jak i generowanie klienta HTTP, co zapewnia spójność w całym systemie bez konieczności ręcznego utrzymywania tej spójności przez dewelopera.
Ten prototyp to podstawa, a nie gotowy produkt. Od tego momentu deweloperzy iteracyjnie go rozwijają, budując logikę biznesową na bazie tego szkieletu, zamiast budować sam szkielet.
Dlaczego twój zespół powinien przyjąć to podejście
Opisany wyżej przepływ techniczny jest interesujący przede wszystkim dla pojedynczych deweloperów. Z perspektywy organizacji wygląda to inaczej: to podejście zmienia skalę tego, co mały zespół może zaprototypować w jednym sprincie, a ta zmiana ma efekt kumulacyjny.
Szybsza droga do pierwszego działającego endpointu. Tradycyjna droga od pomysłu do testowalnego backendu – projekt specyfikacji, konfiguracja tras, uwierzytelniania i bazy danych – zwykle zajmuje kilka dni nawet doświadczonym deweloperom. Podejście wspierane przez LLM skraca ten czas do kilku godzin. Ma to największe znaczenie w dwóch sytuacjach: na etapie wczesnej walidacji (gdy chcesz sprawdzić, czy projekt API ma sens, zanim się na niego zdecydujesz) oraz przy szybkiej reakcji na zmieniające się wymagania (gdy decyzja produktowa wymaga nowego zestawu endpointów i chcesz ocenić to podejście przed napisaniem kodu produkcyjnego).
Jakość wbudowana od samego początku. Ponieważ wygenerowany kod wynika z jawnej specyfikacji OpenAPI, w której od początku zdefiniowano zakresy bezpieczeństwa i odpowiedzi na błędy, prototyp startuje z lepszym zestawem domyślnych rozwiązań niż większość boilerplate’u pisanego ręcznie. Uwierzytelnianie, obsługa błędów i spójne modele danych są obecne od pierwszego commitu, zamiast być dodawane stopniowo. Zespoły, które prototypują w ten sposób, zwykle przenoszą mniej takich braków do środowiska produkcyjnego.
Mniejsza zależność od trudno dostępnego czasu specjalistów. Im bardziej doświadczony deweloper, tym drożej kosztuje angażowanie go do pisania boilerplate’u. To podejście przenosi generowanie rutynowego szkieletu na LLM, dzięki czemu bardziej doświadczeni inżynierowie mogą skupić się na decyzjach, które faktycznie wymagają ich wiedzy: architekturze, modelowaniu danych i logice biznesowej.
Wspólny kontrakt dla całego zespołu. Specyfikacja OpenAPI wygenerowana w kroku 2 staje się wspólnym artefaktem – frontend developerzy używają jej, by zrozumieć dostępne endpointy, inżynierowie QA do pisania testów, a Product Ownerzy do weryfikacji, czy implementacja odpowiada wymaganiom. Ta wartość dokumentacyjna istnieje niezależnie od samego zastosowania związanego z generowaniem kodu.
W Monterail tego rodzaju wspierane przez AI tworzenie szkieletu backendu stało się częścią naszego podejścia do pracy nad produktami na wczesnym etapie.
Backend Flink – gotowa do produkcji architektura mikroserwisów w Go, która rozrosła się z 2 do 11 inżynierów, podczas gdy platforma urosła do obsługi 10 milionów klientów w 60 miastach i 4 krajach – pokazuje, co umożliwiają dobrze zdefiniowane granice usług przy dużej skali.
Zasada jest taka sama: jasno określone kontrakty między usługami, ustalone na wczesnym etapie, znacząco ułatwiają późniejsze skalowanie zespołu, ponieważ interfejs każdego komponentu jest jawny, zamiast być odkrywany przez analizę bazy kodu.
Jeśli twój zespół analizuje, gdzie tworzenie oprogramowania wspierane przez AI może przynieść największe oszczędności czasu, prototypowanie backendu to jeden z najlepszych punktów wyjścia.
Monterail usług tworzenia oprogramowania z wykorzystaniem AI omawia te kwestie integracyjne z zespołami produktowymi z różnych branż.
Skontaktuj się z nami jeśli zastanawiasz się, jak wprowadzić to do swojego sposobu pracy.
Najważniejsze wnioski
Podejście spec-first — czyli wygenerowanie specyfikacji OpenAPI v3 przed wygenerowaniem kodu backendu — daje bardziej niezawodne rezultaty niż bezpośrednie generowanie kodu na podstawie opisów w języku naturalnym. Specyfikacja pełni rolę uporządkowanej warstwy pośredniej, która zarówno ukierunkowuje generowanie kodu, jak i służy jako dokumentacja.
Projekt promptu ma większe znaczenie niż wybór narzędzia. Założenia stojące za promptem systemowym w kroku 2 — wymóg użycia YAML, odpowiedzi na błędy, bezpieczeństwa o ograniczonym zakresie i schematów komponentów — bezpośrednio decydują o jakości wygenerowanej specyfikacji i wszystkiego, co z niej wynika.
Oddzielenie generowania specyfikacji od implementacji backendu (kroki 2 i 3) to nie tylko kwestia porządku organizacyjnego. Dzięki temu LLM otrzymuje na każdym etapie bardziej ukierunkowany kontekst, co ułatwia wprowadzanie poprawek i zwiększa spójność wyników.
Generowanie klienta HTTP na podstawie zwalidowanej specyfikacji (krok 4) jest bardziej niezawodne niż kod klienta generowany przez AI bezpośrednio na podstawie plików implementacyjnych. Wynik działania openapi-generator jest deterministyczny; generowanie klienta przez LLM już nie.
Z perspektywy organizacji argumentem za tym podejściem są szybkość i jakość: godziny do działającego prototypu zamiast dni, przy czym bezpieczeństwo i obsługa błędów są obecne od pierwszego commitu, a nie dodawane po czasie.
FAQ
Marcin Wróblewski
Senior Mobile Developer

Open-source enthusiast, focusing on Dart and Flutter due to their technical excellence. Codeusse’s creator.